Читая плотный документ, агент часто начинает с обзора низкого разрешения, затем тратит ограниченное число увеличенных фрагментов на важные области. Ценность фрагмента отчасти определяется тем, что он позволяет сделать дальше. Если осталось два чтения, поле маршрутизации покажет нужную таблицу. Если осталось одно, то же поле израсходует последнюю попытку, не открывая ответ. В статье, опубликованной 18 ноября, предложен протокол для проверки, учитывают ли визуальные агенты меняющийся бюджет. Публичные свидетельства и привязка ролей к областям остаются прежними, а число оставшихся чтений или ценность действия меняются. Статья об аудите визуальных агентов с парными бюджетами
Метод также отслеживает последствия каждого наблюдения в полном журнале чтения. При заданной модели документа и инструмента чтения он вычисляет оптимальную дальнейшую ценность после каждой истории. Разница между ней и ценностью выбранной агентом области становится поэтапной потерей сбора доказательств. После завершения чтения отдельная метрика оценивает ответ. Такая схема позволяет определить, на каком шаге теряется точность относительно модели задачи.
Авторы применили протокол к контролируемым задачам маршрутизации, многошаговым иерархиям и тридцати отсканированным формам FUNSD. Практический вывод заключается в следующем. Первая попытка модели может выглядеть разумно, но при изменении бюджета или ценности области модель продолжит привычную стратегию. В естественных формах видимая польза кропов зависит от эталона ответа. Процедуры с несколькими кропами могут уступить чтению всей страницы, использовав больше входных токенов.
Один кроп может указать путь к следующему#
Контролируемая задача содержит пять областей документа. Одна является селектором, две другие — возможными ветвями ответа, ещё две — отвлекающими участками. Публичная привязка определяет роль каждой области. Правило задачи показывает, как скрытые биты задают ответ. Каждое чтение возвращает значение области по установленному каналу наблюдения. Для этих контролируемых случаев проверяющий знает априорное распределение и канал, поэтому может точно вычислить ожидаемую точность каждой допустимой последовательности чтений.
В задаче switch селектор сообщает, в какой ветви находится ответ. Если осталось два чтения, лучше сначала открыть селектор, чтобы затем перейти к нужной ветви. Если осталось одно чтение, ответ можно получить напрямую из любой ветви. Селектор уже не успевает направить второй кроп. Поэтому оптимальное первое действие меняется только из-за бюджета.
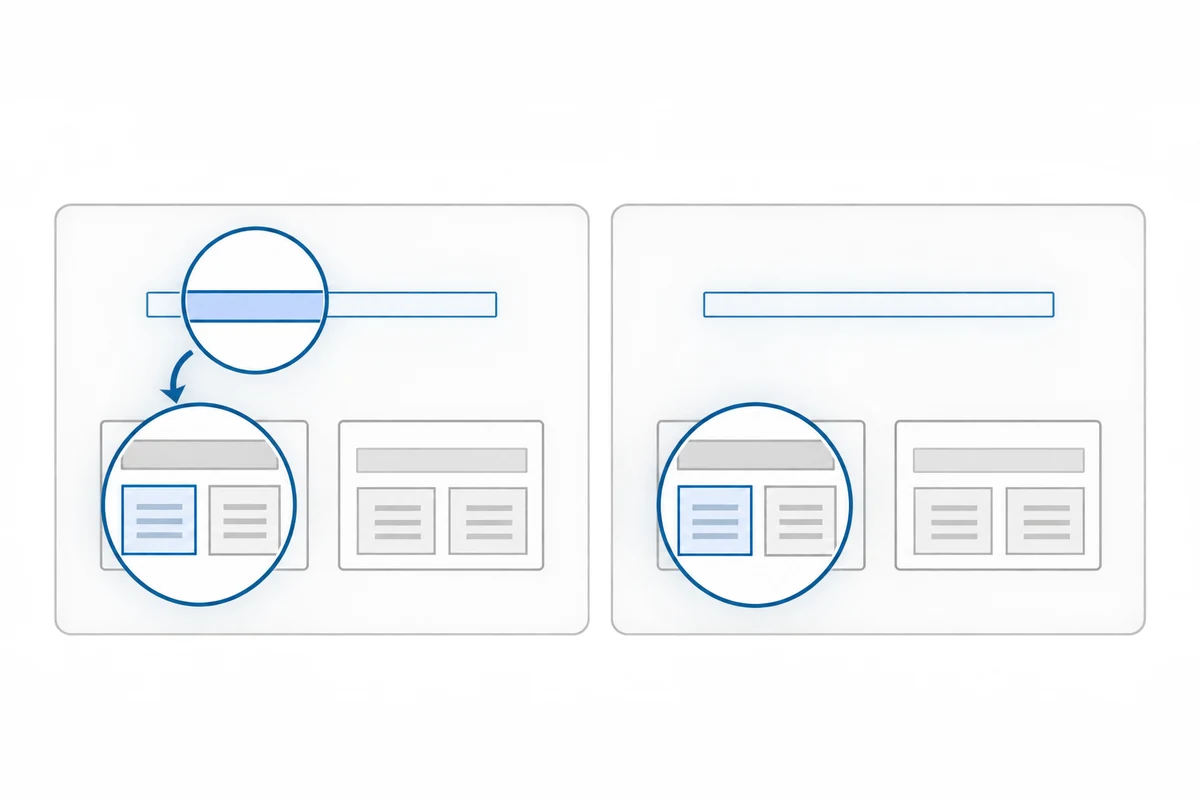
В парных задачах публичные свидетельства и привязка ролей к областям одинаковы. Меняется остаток бюджета или параметр, определяющий ценность действия. Фиксированное предпочтение может выглядеть правильным при двух чтениях, а пара с одним чтением проверяет адаптацию к горизонту. Такая пара различает два объяснения, которые точность на изолированных примерах разделить не может. Модель может понимать роль селектора, но не учитывать число оставшихся попыток чтения.
Та же идея сдвигает границу ценности действия. Ветвь может стать информативнее, если меняется априорная вероятность ответа или надёжность селектора. Эксперимент сдвигает границу, сохраняя остальную сцену. Политика, всегда открывающая селектор, может хорошо работать при одном наборе параметров и чрезмерно выбирать его, когда полезнее прямой ответ из ветви. Чувствительная к ценности политика должна переключаться там, где меняются ожидаемые значения продолжения.
Тест опирается на явную модель задачи. В статье задаются prior скрытого состояния документа и распределение возврата области, после чего перечисляются возможные исходы. Оптимальные решения описывают поведение по этим допущениям и ограничены ими. В реальном документе привязка областей может быть неточной, OCR — шумным, а ошибки полей — коррелированными. Эти обстоятельства отличаются от контролируемой модели и требуют измеренных моделей чтения или отдельных аудитов.
Итоговая точность скрывает маршрут#
Изолированный тест вопрос-ответ записывает, оказался ли окончательный ответ правильным. Он не показывает, какую область выбрал агент, насколько ценным был этот выбор или поменял ли агент политику после результата чтения. В статье рассчитывается значение продолжения для каждой истории. Остаток бюджета, журнал прочитанного и объявленная модель вместе задают действие с наибольшей ожидаемой конечной точностью.
Для каждой прочитанной области аудит фиксирует лучшую возможную дальнейшую ценность и ценность реального выбора агента. Разница составляет потерю получения доказательств. После исчерпания бюджета оценщик вычисляет лучший ответ на основании полученного. Разница между этим ответом и выводом модели становится потерей конечного решения. Сумма разделяет по всей траектории разрыв ожидаемой точности между оптимальной и наблюдённой политиками.
Разложение показывает два вида проблемы. Агент может собрать слабые данные, выбрав области с низкой ценностью. Он также может получить полезные сведения, а затем ответить неверно. Конечная доля ошибок объединяет оба случая. В рамках заявленных prior и канала чтения журнал траектории их различает, сохраняя историю, созданную действиями модели.
В статье приводится пример. При двух оставшихся чтениях оптимален селектор, поскольку он направляет к нужной ветви. Если агент читает его и получает значение, активирующее конкретный шлюз, следующим следует открыть этот шлюз. В сохранённой траектории Qwen3-VL-8B вместо него открывает отвлекающий участок. В построенной задаче это уменьшает условную ценность на 25 процентных пунктов. Затем читается другая конечная область, а шлюз остаётся непрочитанным. Posterior может остаться равным для двух ответов. Тогда финальный ответ бывает неверным относительно сохранённого эталона, но с нулевой потерей терминального решения относительно лучшего возможного выбора модели. Аудит относит ошибку к получению данных, а не к финальному выбору.
Лучшую точность по posterior и наблюдаемую правильность тоже следует различать. Если две гипотезы равновероятны, любой ответ имеет нулевую потерю решения относительно лучшего доступного выбора. При этом максимально возможная точность составляет только 50 %. Агент может принять оптимальное конечное решение при недостатке доказательств. Аудит показывает отдельно достаточность данных и качество решения. Это полезно, когда тестируется и политика наблюдения, и способность ответить.
Парные результаты выявляют устойчивое предпочтение селектора#
В работе пять открытых моделей vision-language проверяются на сорока парных задачах маршрутизации каждая. При справедливом prior и чтениях без шума ветвь оптимальна, когда осталась одна попытка, а селектор — при двух. Лучшее неоптимальное действие в этих якорных случаях теряет 25 пунктов. Ни одна из пяти открытых моделей не совершает оптимального переключения от ветви к селектору в сорока парах.
Некоторые модели выбирают селектор во всех парных условиях. Qwen3-VL-32B делает это во всех 2 320 подтверждающих запросах на получение данных. Другие иногда выбирают ветви или отвлекающие области, но тоже не делают правильного переключения на сорока якорях. Средняя потеря в этих специально подобранных случаях высока и составляет от 12,50 до 15,62 процентного пункта. В других ситуациях около порога средняя потеря равна всего 0,59–0,85 пункта. Низкое среднее по слабодиагностичным случаям может скрывать ригидную стратегию. Контрфактическая пара явно подводит поведение к границе решения.
Такое поведение можно изменить. Хостинговая GPT-5 mini оптимально переключается в 48 из 48 пар с изображением и картой и в 47 из 48 при одной карте. GPT-4.1 делает 44 из 48 в протоколе только с картой, тогда как вариант «изображение плюс карта» сохраняет предпочтение селектора и не показывает переключений. Эти модели работают через собственные датированные endpoints и протоколы. Они показывают, что в задаче возможно учитывать бюджет, но не служат контролируемым парным сравнением с открытыми моделями.
Авторы также двигают границу ценности, меняя prior и надёжность селектора. При надёжности 0,74 четыре профиля дают разные значения преимущества селектора: в двух лучше ветвь, в двух — селектор. GPT-4.1 выбирает селектор во всех 864 решениях. GPT-5 mini с низким усилием рассуждения делает много оптимальных выборов в целом, но сохраняет одну и ту же ролевую склонность в большинстве семейств каждого профиля. На отложенных семействах модель надёжности предсказывает её выбор лучше, чем подписанное преимущество ценности действия.
Это вывод о поведении политики в конкретной модели задачи. Авторы не утверждают, что модель совсем не понимает бюджет или устройство документа. Простое правило в пользу селектора может хорошо работать в обычных условиях. Парные случаи отличают привычный фиксированный выбор от политики, чувствительной к числу оставшихся чтений и ценности действия. Это различие важно при жёстком ограничении на число кропов.
Потери растут после первого чтения#
Авторы расширяют контролируемую задачу до иерархии из восьми областей. Корень ведёт к одному из двух шлюзов, каждый — к одному из четырёх листьев ответа, и остаётся один отвлекающий участок. Агенту доступны три чтения. Хороший первый кроп должен сопровождаться полезными дальнейшими решениями, зависящими от каждого ответа инструмента.
В 160 эпизодах на checkpoint потеря первого чтения мала и составляет от 0,18 до 0,96 процентного пункта. Совместная потеря второго и третьего чтений варьирует от 22,20 до 26,76 пункта. Терминальная потеря решения добавляет 5,73–14,30 пункта. Наблюдаемая точность находится в диапазоне 53,75–57,50 %. Большинство измеренных ошибок возникает после первоначального наблюдения, когда агент должен выбрать следующий участок с учётом новой информации.
Тот же результат появляется в сбалансированном профиле без шума. Потеря первого чтения составляет от нуля до 3,12 пункта, дальнейших — от 29,38 до 36,88. Даже в контроле, где все допустимые первые действия равны, дальнейшая потеря остаётся измеримой. В протестированных иерархиях основная проблема связана с политикой продолжения. Одношаговое решение может выглядеть хорошим, хотя вся траектория заметно уступает точному эталону.
Точные значения оценщика зависят от модели задачи. В контролируемых условиях известны привязки областей, prior и каналы возврата, поэтому можно перечислить все состояния. В открытых сценах prior и модель наблюдений нужно обучить или приближённо оценить. Ошибки значений повлияют на атрибуцию потерь. Авторы указывают это как ограничение. Расчёт точен относительно объявленной модели, которая может упрощать настоящий процесс работы с документами.
Эталон задачи также определяет полезность. Если метка селектора шумная или привязка регионов неуверенная, теоретически оптимальный путь по заданной карте может быть неоптимален для реального сканера. Контролируемые задачи используют проверенные привязки, чтобы изолировать выбор. Производственная оценка должна также проверить локализацию и качество распознавания, потому что правильная роль области бесполезна, если кроп не захватил её текст.
Результаты на формах меняются с эталонным ответом#
Естественный документный раздел использует 30 страниц FUNSD. На каждой есть обзор низкого разрешения и шесть увеличенных кропов в фиксированной сетке 3×2. Исследование сравнивает выбор одного кропа с общим равномерным считывателем. Также сравниваются последовательная политика из двух кропов и чтение всей страницы, которое обрабатывает изображение одним вызовом. Референсы заданы двумя способами: исходные метки и отредактированный авторами вариант.
По отредактированному эталону Qwen3-VL-8B отвечает правильно на 24 из 30 страниц после выбора одного кропа, что на 24,44 пункта выше равномерного чтения. При повторной оценке тех же сохранённых решений с исходными текстами прирост составляет 10,56 пункта, а интервал пересекает ноль. Формулировка эталона меняет, что считается правильным. Например, исходный ответ объединяет два соседних поля формы. Удаление соседнего текста из исправленного референса превращает сохранённый ответ из ошибочного в верный.
Полная процедура двух кропов не превосходит чтение страницы целиком. Qwen3-VL-8B правильно отвечает на 21 из 30 страниц после двух кропов, а при чтении всего изображения — на 25. Процедура кропов делает три вызова и обрабатывает около 1 662,8 входного токена на страницу. Нативное чтение использует один вызов и 824,8 токена. InternVL3.5-8B также верно отвечает на меньшее число страниц при использовании кропов. Дополнительное наблюдение не обязательно повышает точность.
Определение оценки вносит неопределённость в видимую выгоду. Для тех же сохранённых ответов статья пересекает исходный/изменённый текст референса с двумя правилами нормализации. У Qwen3-VL-8B один лишь пересмотр текста повышает прирост выбора кропа на 12,22 пункта. Одна нормализация знаков и пробелов добавляет 10 пунктов. Их взаимодействие уменьшает комбинированное изменение на 8,33 пункта. Для точного совпадения важно публиковать исходную формулировку и правила нормализации.
Результаты форм ограничены и зависят от эталона. Несколько интервалов проходят через ноль. Авторы не считают это общим доказательством пользы кропов для чтения документов. Референсы редактировались с помощью ИИ и не прошли независимую человеческую проверку. Публичные страницы FUNSD также могли входить в обучающие данные. Этот раздел служит одновременно аудитом оценочного процесса и сравнением стратегий наблюдения.
Что может установить протокол#
Парные аудиты с разным бюджетом различают стратегии, которые выбирают одну область при данном бюджете, но должны расходиться при смене оставшихся чтений. Точные значения продолжения измеряют цену решения в контролируемых задачах. Учёт полной траектории указывает, потерялась ли точность при сборе информации или в окончательном ответе. Протокол позволяет исследовать последовательное наблюдение, а не только финальную правильность.
Метод требует заданного prior скрытой сцены, модели возврата свидетельств и проверенных привязок ролей задач к областям, чтобы точно считать ценности. Контролируемые эксперименты спроектированы под эти предположения. Раздел о реальных формах использует измеренную точность, не заявляя точную модель апостериорного распределения. Открытые документы добавляют неопределённую локализацию, шум OCR и коррелированные ошибки полей. Для переноса точных расчётов понадобится модель наблюдений, чья ошибка тоже измерима.
Покрытие моделей ограничено. Пять открытых систем разделяют языковые компоненты на базе Qwen. Они работают со структурированными текстовыми состояниями при ограниченном декодировании и без отдельной стадии рассуждения. Две хостинговые системы используют разные датированные endpoints и протоколы, поэтому демонстрируют достижимость поведения, а не парное сравнение. Другие семейства, свободное рассуждение и обучаемые каналы визуального чтения ещё предстоит проверить.
Основные данные поддерживают конкретный вывод. В представленных контролируемых задачах открытые модели часто продолжают читать фиксированный селектор, хотя пара с другим бюджетом делает ветвь более ценной. В длинных иерархиях большая часть потерь относительно точной модели возникает после первого чтения. На сканированных формах результат зависит от эталона, а кропы нужно сравнивать с чтением всего изображения и токенами. Эти наблюдения ограничены конструкцией задач и набором моделей.
Контролируемые панели также отделяют политику от интерфейса наблюдения. В основном аудите маршрутизации роли регионов заданы, а чтение возвращает структурированные значения. Это упрощает проверку выбора после получения сведений, но оставляет за рамками точность локализации и качество кропа. Панель естественных форм вновь включает изображения и вырезки, с другими источниками неопределённости. Модель может выбрать нужное поле, но промахнуться по тексту. Или прочитать верное поле, но неверно понять неоднозначную метку. Для определения причин нужны отдельные контроли.
Точный эталон статьи перебирает значения продолжения по объявленной вероятностной модели. Для заданной истории, бюджета, prior сцены и канала чтения оценщик вычисляет ценность действия. Это подходит синтетическим контролируемым задачам, где можно перечислить все состояния и ответы. Для реальных форм скрытое состояние и канал наблюдения точно неизвестны. Поэтому авторы показывают эмпирическую точность и парные сравнения документов, не распространяя гарантию точного posterior на эту панель.
Различие важно для интерпретации. Контролируемые задачи дают чистую пару: публичные свидетельства и привязка регионов фиксированы, меняется бюджет или ценность. Реальные формы показывают пользу кропов на небольшом документном наборе. Они не задают точную ожидаемую ценность каждого кропа, поскольку ответы в референсах и модель чтения сами неопределённы. Две панели отвечают на разные вопросы.
Для внедрения важна полная траектория#
В развёрнутом агенте каждый кроп имеет предельную стоимость. Он добавляет токены, вызов, задержку и риск ошибочного чтения. Оценка без лимита чтений не показывает полезность политики под фиксированным бюджетом. Тест с одним бюджетом не выявляет, меняется ли выбор, когда попыток остаётся меньше. Парный протокол обнаруживает чувствительность к бюджету в контролируемых условиях.
Аудит полной траектории задаёт более практический вопрос. Начиная с обзора и фиксированного лимита, что агент выбирает после каждого ответа и какой даёт итог? Поэтапная потеря приобретения может указать, что чтение области не принесло ожидаемой ценности. Конечная потеря решения показывает трудности при сочетании уже собранных свидетельств. Отчёт рядом с итоговой точностью делает слабый результат более диагностируемым и помогает сравнить интерфейсы, политику кропов и представление состояния.
Доверительная проверка требует определить несколько вещей. Нужно задать допустимые области, способ генерации или чтения результата, правило ответа и единицу оставшегося бюджета. Для естественных форм также необходимы проверка эталонных ответов, фиксация обработки изображения и сопоставимые условия базового чтения всей страницы. Политика кропов должна сообщать число дополнительных вызовов и площадь входного изображения, а не только точность. Это увеличивает трудоёмкость проверки, но делает выводы аудируемыми.
Открытые модели в статье используют ограниченные форматы выхода без выделенной стадии рассуждения. В рабочем интерфейсе могут быть другие визуальные энкодеры, политика инструментов, кеш, предложение областей или скрытые настройки reasoning. Всё это меняет стоимость и ценность наблюдения. Новое внедрение следует оценивать как полную конфигурацию. Текущее сравнение диагностирует указанные политики и панели, а не задаёт общий рейтинг визуальных агентов.
Для продуктовых команд урок заключается в оценке полной политики наблюдения. Нужно проверять, какую область читает визуальный агент, как он использует результат, меняет ли стратегию при сокращении бюджета и насколько надёжен ответ. Текст эталона, определение кропов, базовый вариант целой страницы и стоимость входных данных должны быть прозрачны. Одной точности ответа недостаточно, чтобы увидеть маршрут к нему.
В статье предложен подробный протокол диагностики этого маршрута для контролируемых случаев. Самый интересный результат — не заявление о более высокой точности, а разрыв между правдоподобным первым чтением и эффективной последовательной политикой. Первый кроп может быть выбран разумно. Последующие решения всё ещё могут игнорировать уже полученную информацию и тратить оставшийся бюджет. Поэтапное измерение помогает найти такую потерю до применения визуального агента в работе с документами, где каждое чтение имеет цену.