Два исследователя представили RFBench 17 ноября как проверку мультимодальных систем для пассивных радиочастотных схем. Каждый из 10 000 двухпортовых макетов имеет несколько представлений. Модель может получить спецификацию, изображение или редактируемые геометрические примитивы, затем сгенерировать макет, преобразовать представление, предсказать отклик или диагностировать конструкцию. Ответ получают электромагнитной симуляцией. Главный вывод авторов заключается в том, что успех на одном этапе не подтверждает следующий. Статья RFBench
Пассивные RF-структуры направляют или изменяют высокочастотный сигнал без активного усиления. Линии передачи, согласующие сети, фильтры и схемы настройки антенн зависят от расположения проводящего металла. Небольшие изменения ширины, зазора, связности или портов способны менять отражение и передачу сигнала в зависимости от частоты. Инженеры поэтому многократно переходят от целевой характеристики к редактируемому макету и полно-волновой электромагнитной симуляции. На рисунке всё может выглядеть аккуратно, хотя электрическая цепь разорвана или ответ не достигает цели.
Этот разрыв мотивирует бенчмарк, соединяющий язык, геометрию и физику. Мультимодальная модель может распознать знакомую схему или выдать правильно оформленный список прямоугольников. Проектирование RF требует также разрешённой структуры, соответствия геометрии заданному представлению и электромагнитного поведения в пределах спецификации. Каждое требование нуждается в отдельной проверке. RFBench разделяет их на семь семейств задач, не позволяя одному простому показателю заменять весь процесс разработки.
Один макет, несколько связанных представлений#
Набор данных содержит 10 000 плоских двухпортовых макетов, созданных процедурными генераторами геометрии. Каждый принятый вариант включает редактируемые прямоугольники и порты, изображение, сетку занятости 16×16, симулированную комплексную матрицу параметров S, структурный класс и метку RF-отклика. Общий идентификатор связывает все представления. Поэтому бенчмарк может проверять, сохраняет ли модель одну металлическую геометрию при переходе от символического описания к картинке и дискретной сетке.
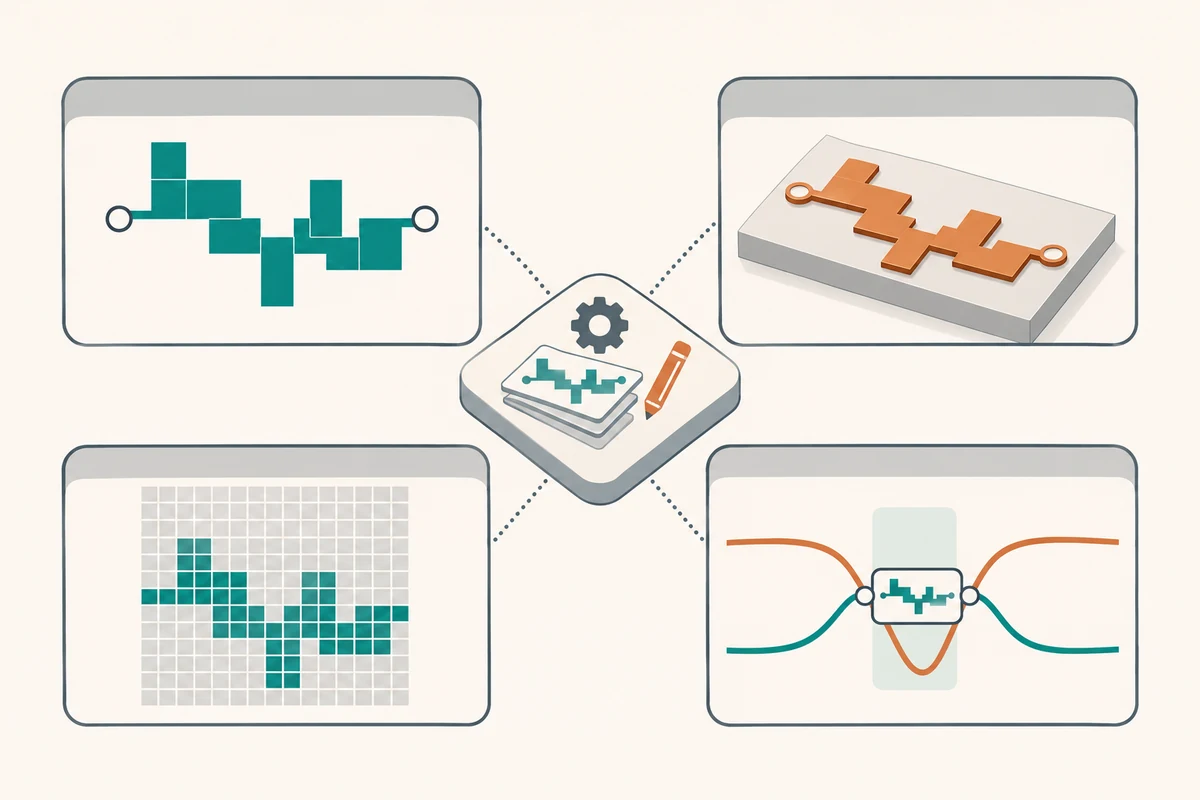
Пять структурных категорий содержат по 2 000 примеров. Это случайно связные макеты, центральные дорожки с ответвлениями по мотивам микрополосковой линии, поворотная симметрия на 180 градусов, зеркальная симметрия слева направо и сверху вниз. Это контролируемые семейства генерации, не выборка всех конструкций коммерческих RF-устройств. Они дают повторяемые примеры связности, симметрии и геометрических мотивов, пригодных для автоматической проверки.
Каждый макет симулируется в ADS Momentum на 201 равномерно разнесённой частоте от 1 до 10 ГГц. Данные сохраняют полную комплексную матрицу рассеяния 2×2. Значения описывают отражение и передачу между двумя портами при смене частоты. На практике инженера интересует поведение всей кривой. Поэтому тест сравнивает точки предсказания и проверяет пассивность, взаимность и другие физические свойства наряду с обычной численной погрешностью. Данные и детали симуляции
Набор сгенерирован, а не собран с измерений изготовленных плат. Процедурные генераторы создают кандидатов, а автоматические проверки исключают конструкции, нарушающие требования, например к связности линий, границам области или портам. Пять семейств сбалансированы в итоговом корпусе. Метки RF-отклика при этом распределены неравномерно, и некоторые классы редки. Поэтому кроме accuracy авторы показывают сбалансированный по классам macro-F1, уменьшая доминирование самых распространённых ответов.
Официальное разбиение оставляет 9 000 дизайнов в обучающем пуле и 1 000 в общем тесте. В отложенной части по 200 вариантов каждого из пяти структурных семейств. T1, T2, T3, T6 и T7 используют одни ID, что позволяет парно сравнивать модели. Для запуска симулятора есть сбалансированное подмножество из 250 сгенерированных макетов, а диагностика конструкции использует 100 общих кейсов. Это разные тестовые панели. Основные результаты статьи получены не на всём корпусе.
Сопоставленные представления делают диагностику ошибок информативнее. Если модель преобразует редактируемые прямоугольники в неправильную сетку, результат указывает на сбой символического преобразования. Если примитивы обрабатываются хорошо, а изображение плохо, различие выявляет ограничение зрительного восприятия. Если оба преобразования успешны, а прогноз отклика неудачен, причина лежит в другом звене. Один показатель смешал бы эти случаи. RFBench сохраняет промежуточные задачи, чтобы было видно, где ломается инженерный процесс.
Семь задач следуют процессу проектирования#
Первая группа просит сгенерировать макет по электрической спецификации на естественном языке. В одной версии модель получает целевые величины четырёх параметров S на трёх частотах. В другой задаётся также структурная категория. Выход — редактируемая геометрия. Показатель валидности проверяет два порта, границу области и связную металлическую дорожку между вводами. Если категория задана, её соответствие считается отдельно.
Целевые значения взяты из симулированной конструкции, поэтому для каждой спецификации существует известная реализующая геометрия. Исходный макет скрыт, и модель не должна в точности восстановить его. Она может достичь той же цели другой допустимой схемой. Это важно для оценки генерации. Бенчмарк проверяет требуемое электрическое поведение и структурные ограничения, а не угадывание скрытого оригинала. Три частоты сокращают спецификацию, представленную модели, а дальнейший тест проверяет полный отклик. Так краткое условие отделено от проверки на всём частотном диапазоне.
Вторая группа проверяет преобразование представлений. Модель превращает редактируемую геометрию в бинарную сетку занятости металлом или строит такую сетку по изображению. В сетке 16×16 содержится 256 ячеек. Точность, полнота, F1 и пересечение над объединением измеряют правильность металлической области. Дополнительно авторы сообщают точное совпадение и нормализованное расстояние Хэмминга. Задача изолирует сохранение формы при переходе между форматами.
Третья группа предсказывает электромагнитный ответ. Модель получает примитивы или изображение и прогнозирует комплексную матрицу параметров S на 201 частоте. Метрики включают комплексную MAE, долю точек «матрица-частота» в пределах 2 дБ, долю частот с допустимой пассивностью, ошибку взаимности и производной спектра. Эти метрики описывают разные свойства. Точность отдельных точек может пропустить физически неверную кривую. Определения задач RFBench
Четвёртая группа запускает сгенерированный макет в ADS Momentum. Синтаксически правильная геометрия всё равно может не импортироваться, поэтому измеряется доля успешных запусков. После полной симуляции проверяется, попали ли все двенадцать целевых величин на трёх частотах в диапазон 3 дБ. Конструкция может успешно симулироваться, но не достичь электрической цели. Отдельные показатели показывают разницу.
Пятая задача посвящена диагностике и улучшению. Модель получает макет, его симулированный отклик и целевую спецификацию. Она решает, требуется ли улучшение, и, когда нужно, предлагает новый вариант. Для решения измеряются accuracy, precision, recall и macro-F1, после чего изменения независимо прогоняются через симулятор. Снижение ошибки цели и улучшение от начала до конца учитывают невалидную геометрию и неудавшуюся симуляцию. Диагноз должен быть верным, а изменение металла обязано действительно улучшить физический результат.
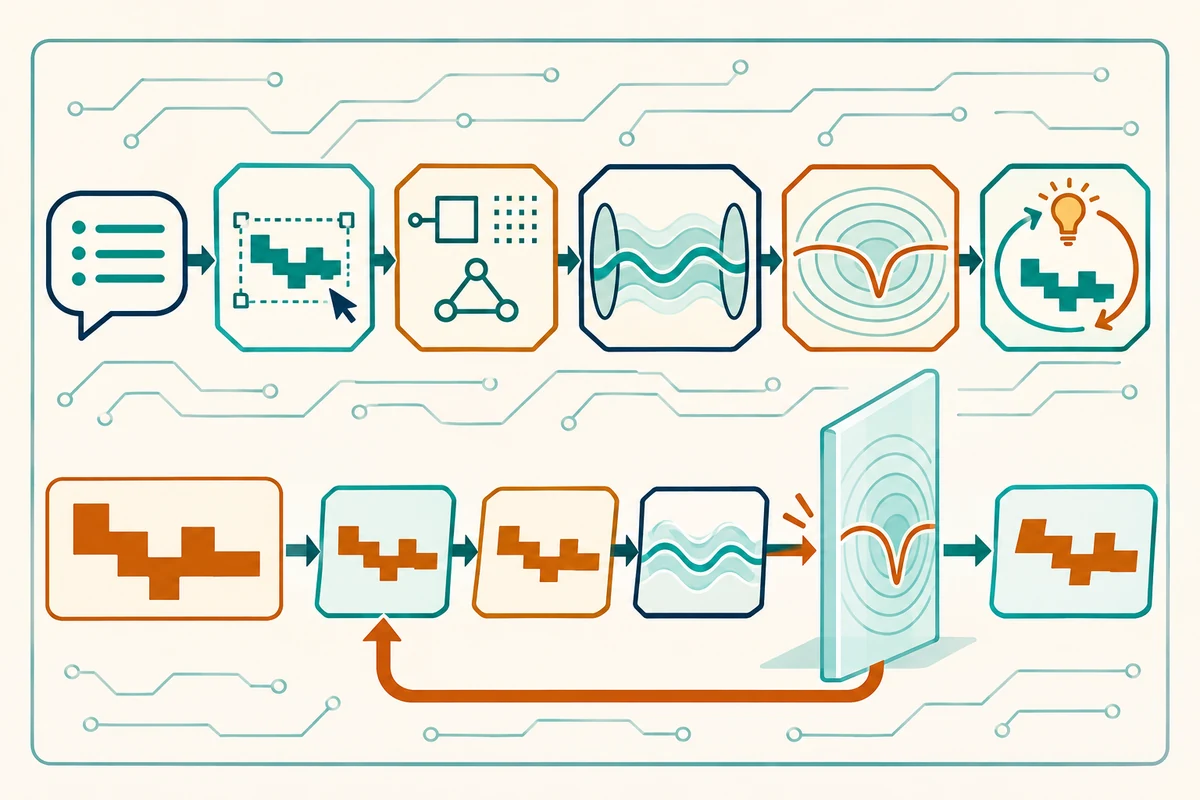
Структурное понимание и классификация отклика завершают набор. В одной задаче модель по примитивам или изображению определяет класс макета и признаки симметрии и связности. В другой она относит симулированный отклик к широкополосному пропускающему, широкополосному затухающему, низкочастотному, полосовому, режекторному или резонансному типу. Эти тесты проверяют распознавание свойств конструкции и ответа, но не заменяют полное проектирование.
Авторы не используют один суммарный балл как главный рейтинг. У задач разные выходы, метрики и физический смысл. Единое ранжирование потребовало бы выбрать веса и компромиссы. Вместо этого полезнее прочитать профиль. Модель может безошибочно переводить геометрию, но неверно предсказывать отклик. Другая способна классифицировать ответ и провалить создание связного макета. Раздельные результаты помогают решить, для какой стадии разработки можно использовать модель.
Валидная геометрия — лишь первый рубеж#
Неадаптированные модели часто создавали внешне правдоподобные макеты, которые не проходили составные структурные проверки. Некоторые почти всегда размещали маркеры обоих портов, но все их базовые версии получили ноль процентов структурной валидности при генерации по спецификации. Валидность требует одновременно портов, размещения в области и связного пути металла. Правильного формата или двух концов недостаточно для пригодного RF-макета.
RF-специфичная настройка Qwen3-VL-8B резко меняет этот результат. Supervised fine-tuning достигает структурной валидности 82,7 % в одной задаче генерации и 86,0 % при ограничении категорией. Следующий этап GRPO достигает соответственно 83,2 и 86,4 %. Полное соответствие категории составляет 85,7 и 85,2 %. Эти баллы показывают, что примеры и адаптация учат модель выполнять контракт выхода макета. Они измеряют структуру, а не успешный электрический отклик.
Закрытая симуляция показывает следующий разрыв. Обе адаптированные версии получили 100 % успешных запусков ADS на 250 сгенерированных макетах. При строгом требовании, чтобы все двенадцать целевых величин были в 3 дБ, прошли только 1,6 % результатов SFT и 2,8 % GRPO. Это показательно. Геометрия может пройти структурное правило и запуститься в промышленном симуляторе, но не выполнить электрическую цель. Обратное RF-проектирование намного сложнее создания синтаксически и структурно валидного металла.
Это различие важно для утверждений об инженерной автоматизации. Если модель генерирует макет, запускающийся в ADS, она проходит технический запуск. Она ещё не обязательно создала фильтр, согласующую сеть или схему настройки антенны с обещанными характеристиками. Цель описывает электрическое поведение в диапазоне частот. Общая форма может быть верной, тогда как отражение, передача или полоса пропускания всё равно не совпадут. В аккуратном отчёте доли запусков и успеха спецификации разделяются.
Цели бенчмарка взяты из симулированных макетов, поэтому для каждой существует хотя бы одна известная реализующая геометрия. Точно повторить её не требуется. Так создаётся контролируемая обратная задача, но её диапазон ограничен пространством, представленным генератором и симулятором. Реальное изготовление добавляет материалы, производственные допуски, упаковку, разъёмы и условия измерения, которых в текущих задачах нет.
Похожие формы могут иметь разные физические свойства#
Перевод представлений — задача с наибольшим эффектом адаптации. Лучший неадаптированный F1 металла равен 31,4 % для примитивов и 48,2 % для изображений. Ни одна модель не выдала точное совпадение сетки. После специального RF-обучения варианты Qwen3 превысили 99,97 % foreground F1 для обоих входов, точное совпадение составило 99,0–99,5 %. На задаче дискретного преобразования набор практически насыщен.
У этого результата есть смысл, но он измеряет восстановление сетки занятости 16×16. Он не доказывает, что модель понимает все электрические последствия металлического узора. Обучение и тест используют те же процедурные семейства. Отложенные конструкции оценивают перенос на новые примеры внутри сгенерированного корпуса. Возможность переноса на геометрию вне генераторов и производственные условия остаётся открытым вопросом.
Предсказывать ответ сложнее. Среди исходных моделей лучше всего сбалансирован Claude 4.5. В пределах 2 дБ оказалось 28,0 % точек «матрица-частота» для примитивов и 27,0 % для изображений. Qwen3 SFT поднимает их до 62,6 и 64,1 %. GRPO меняет значения лишь немного, до 62,8 и 64,1 %. Комплексная ошибка предсказания тоже падает. Примеры под надзором помогают, а дополнительная оптимизация вознаграждения даёт скромный выигрыш в этой задаче.
Проверки физики усложняют простой рейтинг. Доля пассивности показывает, выполняет ли предсказание физическое ограничение. Взаимность проверяет ожидаемое отношение прямой и обратной передачи в смоделированной структуре. Ошибка спектральной производной учитывает изменение отклика по соседним частотам. Одна исходная модель изображений выполнила требование пассивности в 98,5 % случаев, но только 11,1 % точек уложились в 2 дБ при большой ошибке взаимности. Кривая способна пройти одну физическую проверку и оставаться численно неверной или схлопнутой.
После адаптации доля пассивности падает примерно до 72 %, тогда как точность отклика, взаимность и спектральная согласованность улучшаются. Специализированная CNN-суррогатная модель даёт лучшую поточечную точность, 84,4 % предсказаний находятся в 2 дБ. Однако критерию пассивности соответствуют лишь 28,3 % частот, а ошибки взаимности и спектральной производной выше, чем у адаптированных языковых моделей. Здесь нет одного бесспорного победителя. Способы по-разному сочетают численные и физические показатели.
Вознаграждение может оптимизировать суррогат вместо результата#
Задача диагностики показывает различие между правильным решением и полезной переработкой. GPT-5.4-mini лидирует в диагностике с accuracy 89,0 % и macro-F1 88,4. SFT повышает диагностический macro-F1 Qwen3-VL-8B с 51,0 до 58,6 %. GRPO достигает 55,5 %. Но доля улучшения от начала до конца после симуляции ADS падает с 48,4 % у базовой модели до 45,3 % после SFT и 35,9 % после GRPO. Медианное снижение ошибки после адаптации также близко к нулю.
Статья связывает расхождение с двумя элементами обучения. Случаи диагностики T5 исключены из SFT и GRPO. Награда GRPO приходит от обученного суррогата, а не от полного волнового симулятора для каждого кандидата. Система может лучше оптимизировать балл суррогата, не предлагая более эффективные физические изменения. Результат симулятора показывает, насколько награда согласуется с реальной задачей.
Такое явление встречается и в инженерии ИИ. Модель оптимизирует доступный обучению и дешёвый сигнал, тогда как продуктовая цель требует более полной проверки. Проверка формата дешевле симуляции, суррогат быстрее полно-волнового расчёта. Награда, связанная с желаемым результатом, может ускорить обучение, но эту связь нужно проверять на отложенных примерах и фактических критериях приёмки. RFBench сообщает о расхождении вместо того, чтобы выдавать рост награды за прогресс в проектировании.
Классификация ответа также показывает значение выбора метрик. После настройки точность превышает 94 %, а macro-F1 составляет около 74 %. Шесть классов отклика несбалансированы, некоторые редки. Общая точность сильнее отражает распространённые классы. Macro-F1 делает вклад каждого класса заметнее. Оба числа помогают понять поведение. Публикация лишь одного скроет слабое распознавание редких категорий.
Физическая область бенчмарка ограничена#
RFBench сосредоточен на симулированных плоских двухпортовых макетах. Он не моделирует производство и измеренные устройства. Сетка занятости 16×16 описывает небольшое контролируемое пространство, ADS Momentum даёт симуляцию отклика. Так получается повторяемая связь геометрии с электромагнитным поведением. Реальное производство добавляет материалы, допуски, укладку слоёв, упаковку, разъёмы и шум измерений.
Генерация данных тоже определяет доступное модели обучение. Пять процедурных семейств геометрии дают по 2 000 конструкций каждое. Случайное разбиение по дизайн-ID удерживает тысячу официальных примеров и оставляет 9 000 в пуле обучения. Авторы сообщают о согласованных примитивах, изображениях, сетках и откликах, а также о проверках дубликатов и растеризации. Это полезный контроль данных. Случайный holdout всё равно использует те же семейства генераторов, поэтому он не подтверждает работу на всех топологиях, которые инженер RF может начертить.
По словам авторов, dataset опубликован по лицензии CC BY 4.0, код — MIT. При проверке ссылок из статьи адрес GitHub возвращал 404, а страница Hugging Face требовала аутентификации. Читатель может изучить статью и опубликованные результаты, а воспроизведение зависит от доступности ссылок на код и данные. Доступность может измениться, поэтому заявление о выпуске и возможность фактически скачать артефакты стоит отслеживать отдельно. Статья RFBench и ссылки на материалы
Результаты настройки также привязаны к конкретной базовой модели и рецепту обучения. Авторы применяют RF-специализированные SFT и GRPO к Qwen3-VL-8B. Адаптация заметно улучшает оценки по этим задачам. Статья не устанавливает стоимость подготовки аналогичных данных для организации, выигрыш на её цепочке CAD или перенос на коммерческие изделия. Для этого нужны отдельные опыты на целевом процессе.
Что инженеры могут узнать из профиля оценок#
Полезнее всего читать RFBench как последовательность проверок. Спецификация переводится в геометрию. Геометрия должна корректно разобратьcя, остаться в области и обеспечить связь. Симулятор должен запуститься. Отклик должен соответствовать частотным и физическим требованиям. Диагноз должен привести к изменению, которое уменьшит фактическую ошибку. Если оценка прекращается на первой проверке, она рискует переоценить сделанную работу.
Результаты подсказывают инженерным командам конкретные направления. Ограниченная схема вывода и точное обучение геометрии могут улучшить задачи представления. Электрическое поведение всё равно надо проверять симулятором. Суррогатные награды следует сверять с полным симулятором на парных отложенных примерах. При дисбалансе классов полезны макро-метрики. Для генерации, симуляции и улучшения могут потребоваться разные тестовые подмножества из-за разной цены задач.
Выбор модели зависит от этапа работы. Если команде нужен перевод макетов или классификация структуры, баллы адаптированной модели заслуживают внимания в рамках этого бенчмарка. Если задача требует выполнить все электрические спецификации, строгий успех на уровне 1,6–2,8 % показывает большой остаточный разрыв. Решение зависит от этапа автоматизации и остающейся проверки человеком. Помощь в представлении геометрии уже может быть полезна, даже если автономное обратное проектирование ненадёжно.
Авторы RFBench предлагают семь задач, общие представления данных и симуляторные метрики для области без сопоставимого единого теста. Самый ясный результат — разрыв между изученной формой и физической функцией. Модели могут научиться генерировать валидную форму и почти точно воспроизводить дискретную сетку занятости. Предсказание плотного электромагнитного отклика сложнее. Успешное выполнение всех требований после симуляции ещё сложнее. Такой профиль информативнее широкого заявления, будто модель умеет проектировать RF-цепи.
Следующими доказательствами должны стать открытые материалы, независимый повтор результатов, более широкий набор геометрий и измерения физических устройств. Симулятор даёт повторяемую модель физики, но изготовленные детали добавляют допуски и паразитные эффекты, которых синтетические данные не разрешают. Команды могут использовать описанные задачи, чтобы локализовать, где модель ошибается. Текущий бенчмарк задаёт полезный тест и сообщает о результатах адаптации. Его главная ценность — найти пробелы между изображением, макетом и работающей высокочастотной схемой.