Оценка языковой модели начинается с вопроса о выборке. Исследователям могут быть доступны сотни задач, а модель способна пройти одну попытку и провалить другую. Каждый выход тратит время или деньги. Один ограниченный бюджет может покрыть больше типов задач или измерить вариативность за счёт повторения меньшего подмножества. Одна точечная оценка скрывает неопределённость, связанную с этим выбором. В статье, пересмотренной 18 ноября, предлагается использовать повторные результаты для сужения доверительных интервалов с сохранением статистической гарантии покрытия. Работа описывает дизайн оценки и его конкретную доказательную базу. Статья об оценке LLM с фиксированным бюджетом
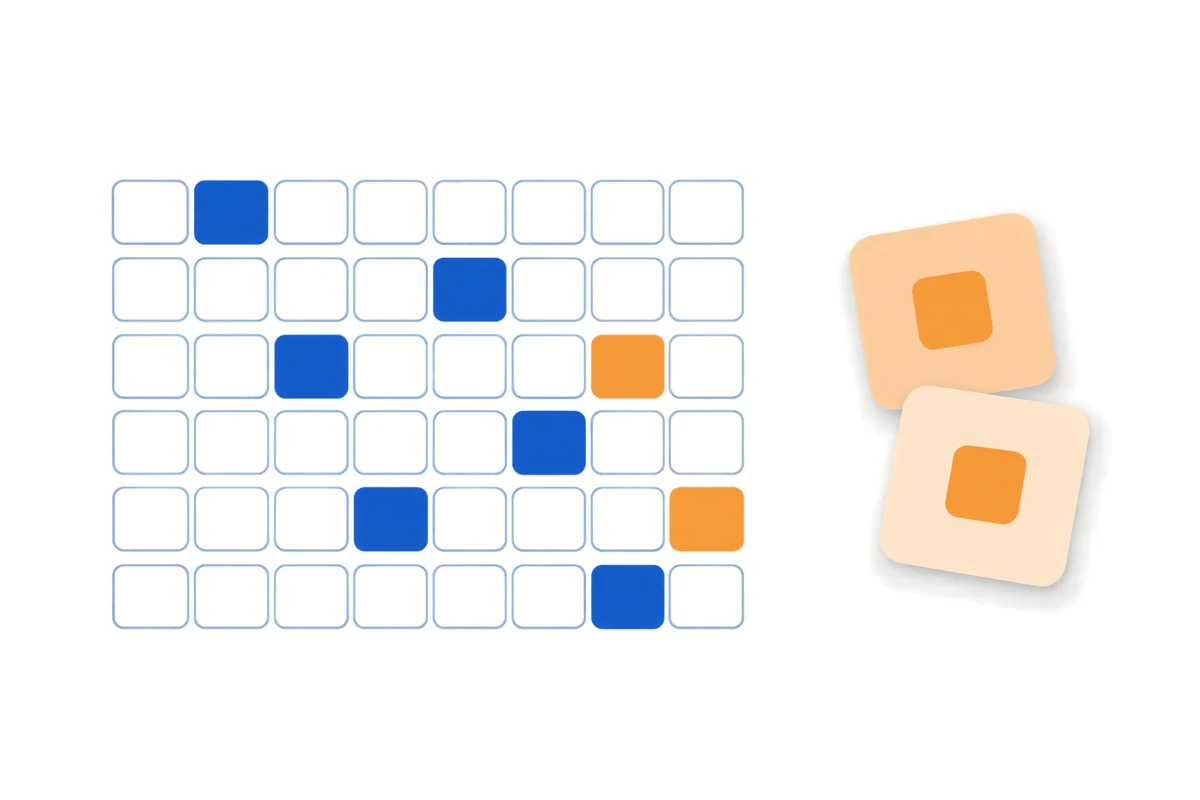
Предложение начинается с практического примера. Возьмём тест программирования на 880 задач с пятью запланированными запусками каждой. Всего получится 4 400 исходов, но бюджет позволяет изучить только 1 100. Нужно выбрать, какие из них включить в выборку. Прямой метод равномерно выбирает 1 100 пар «задача-запуск» из всей сетки. Обсуждаемая схема сначала покрывает каждую задачу один раз, затем распределяет оставшиеся 220 запусков по случайно выбранной части. Если повторные результаты на задаче совпадают, эти проверки дают сведения о скрытой вариативности и общем запланированном балле.
Рядом с баллом модели стоит вопрос точности#
Оценка вычисляет величину для конкретного набора задач, запусков и настроек. Авторы называют заранее указанный набор фиксированной когортой. Он может включать версию модели, запросы, параметры генерации, вопросы теста и число попыток для каждого вопроса. В примере с программированием целевой показатель — среднее всех 4 400 запланированных исходов пар «задача-запуск». Определение этой цели задаёт смысл доверительного интервала.
Исследователи часто сосредоточены на оценённом среднем. Если модель проходит 72 % выборки, число легко сравнить с другой версией. Но один или два процентных пункта могут иметь значение для решения о продукте, когда оно близко к порогу. Команда может решить, выполнены ли критерии выпуска, нужна ли следующая фаза тестирования и оправдывает ли кажущееся улучшение стоимость. Интервал показывает неопределённость оценки и то, лежат ли правдоподобные значения по обе стороны порога решения.
Более узкий интервал при той же доверительной вероятности помогает разрешить больше сравнений. Здесь есть два условия. Интервал должен сохранить заданную гарантию покрытия, а оценка — потратить столько же ресурсов. Снижение уровня доверия сузило бы его, изменив смысл обещания. Дополнительные тесты тоже сузили бы интервал, повысив стоимость. Вопрос статьи состоит в том, как эффективнее распределить доступные выходы, сохранив оба условия.
Этот вопрос особенно актуален для стохастических моделей и агентов. Задача может завершиться успехом в одном запуске и неудачей в следующем из-за сэмплирования, инструментов, выполнения кода или длинной цепочки рассуждений. У оценки два направления. Межзадачная выборка показывает широту. Повторения одной задачи показывают вариативность. Весь бюджет, направленный на одну ось, оставляет неопределённость другой. Соотношение зависит от задач и плана повторов.
Для цели также нужна заранее объявленная система баллов. В статье рассматривается двоичный сценарий, где каждый запуск заканчивается определённым успехом или неудачей. В бенчмарке агентов запуск может включать последовательность ответов модели или вызовов инструментов. Единицей стоимости в математической гарантии служит выход или эпизод. Бюджет для выбранного запуска учитывает его максимальную длину. Это позволяет задать жёсткий предел. Число API-токенов, прошедшее время или доллары не измеряются автоматически, поскольку длина ответа и инфраструктура меняют их расход.
Фиксированная когорта даёт сравнениям устойчивую основу. Она не охватывает все возможные задачи и будущие выборки. Балл описывает запланированные задачи, снимок модели и параметры генерации, которые задают когорту. Если продуктовая команда меняет запросы в середине оценки, меняются и условия измерения. Интервал для исходной сетки не учтёт это изменение. Оценку можно заново спроектировать с новыми настройками и определить новую когорту. Такая дисциплина помогает отделить улучшение модели от последствий пересмотра списка задач, числа попыток или версии стенда выполнения. Вопрос измерения при этом задан явно.
Повторы раскрывают различия между запусками одной задачи#
Одно наблюдение на задачу может оценить среднее при равном весе задач, но почти ничего не говорит о том, насколько различались бы остальные запланированные запуски. Если одна попытка завершилась успехом, нельзя по ней заключить, что следующие четыре также пройдут. Доверительный интервал должен учитывать возможные скрытые исходы, включая когорты с сильной вариативностью внутри задач.
Оценка и точность — разные вещи даже в случае, когда среднее выборки случайно равно среднему всех запланированных исходов. Выборка может точно попасть в цель, хотя неопределённость непросмотренных результатов остаётся высокой. Интервал должен соблюдать заявленное покрытие для каждой фиксированной когорты. Он не может работать лишь в частном случае, когда все повторные результаты совпадают.
Повторные запуски работают как проверки-аудиты. В некоторых задачах метод берёт два различных исхода и считает их расхождения. Малое число расхождений говорит о возможной стабильности результатов внутри задачи. Расхождение предупреждает, что следующая попытка может изменить итог. Метод превращает это наблюдение в ограничение для скрытой вариативности и способен сузить интервал. Одна успешная попытка такого сравнения не даёт. Она может быть типичной или чрезвычайно удачной. Повторы показывают вариацию в запланированном наборе, даже пока весь набор не виден.
Метод не предполагает вероятностную модель того, как конкретная задача формирует исходы. Вместо этого он случайно выбирает запланированные запуски из фиксированной когорты и строит интервал с заданным покрытием для любого возможного набора результатов. Это полезно, когда оценщик не может обосновать сильные предположения о вариативности модели. Гарантия при этом зависит от схемы выборки и указанной конечной совокупности.
Интервал с информацией о наблюдённых расхождениях ведёт себя интуитивно на стабильных задачах. Совпавшие выборки запусков согласуются с низкой внутригрупповой вариативностью. Несовпадающая пара показывает, что следующая попытка может изменить результат. Расчёт использует наблюдение для ограничения скрытых исходов, сохраняя пространство непросмотренных значений. Один успешный результат не даёт подобного сравнения. Он может быть типичным или необычно благоприятным. Повторение помогает оценить вариативность плана даже при неполном наблюдении.
Для покрытия всех задач метод равномерно выбирает по одному запуску на каждую, а затем второй запуск для случайного подмножества. Выбор происходит до просмотра исходов. Это важно, потому что подбор повторов на основании прежних успехов или неудач мог бы исказить оценку. Случайный выбор делает включение проверяемым. Теоретическая часть рассматривает и более адаптивные политики, а также задаёт границы для схем, где дальнейшие решения зависят от прежних исходов.
Что означает покрытие доверительного интервала#
95-процентный доверительный интервал — это процедура, которая покрывает целевое значение как минимум в 95 % повторных случайных выборок из одного и того же фиксированного набора запланированных исходов. Это не значит, что после получения данных фиксированный балл с вероятностью 95 % находится внутри конкретного интервала. Вероятностное утверждение относится к процессу выборки. Интервал может менять ширину на основании наблюдений, но обязан сохранять обещанное покрытие. Полная версия статьи
Авторы называют «честными» интервалы, выполняющие условие покрытия для любой фиксированной когорты. Это сильная гарантия. Она включает вариацию между запусками одной задачи, различия между задачами и возможную зависимость наблюдений. Поэтому метод не может просто вывести низкую неопределённость из удачной выборки. Он ограничивает диапазон того, что ещё могут содержать непросмотренные результаты.
Если запуск заканчивается при первом решающем успехе или неудаче, ранняя остановка может экономить ресурсы. Жёсткий бюджет также должен выдерживать трудную когорту, где событие наступает только в конце каждого запуска. Тогда незавершённый путь не раскрывает итог, и оценщик может закончить лишь ограниченное количество полных запусков. В статье доказана нижняя граница среднеквадратичной ошибки в этой ситуации. Она показывает разницу между удобной практической политикой и гарантией для каждой фиксированной когорты.
Авторы доказывают оптимальные скорости сужения ширины интервала для когорт, где запланированные результаты совпадают внутри каждой задачи. Условия рассмотрены с обязательным покрытием и с разрешением пропускать задачи. При полном покрытии ширина зависит и от числа задач, и от дополнительных повторов. Если некоторые задачи можно не выбирать, сэкономленные первые наблюдения идут на повторы, однако интервал также учитывает неопределённость по пропущенным задачам. Оптимальный темп меняется, потому что в оценке присутствуют оба источника неопределённости.
Эти скорости описывают теоретический режим худшего случая. Они не гарантируют фиксированное сокращение для новой модели. Частые расхождения свидетельствуют о заметной внутритестовой вариативности. Согласованные результаты позволяют сузить границу ошибки в рамках гарантий и дизайна выборки. Реальная выгода зависит от числа задач, запланированных попыток, бюджета, наблюдаемых расхождений и требований к покрытию.
Полное покрытие и повторные проверки требуют компромисса#
При полном покрытии оценщик получает хотя бы один результат по каждой задаче. Это полезно, когда каждый пункт бенчмарка может влиять на решение о выпуске либо команде нужен полный профиль. Повторы расходуют выходы, которые могли бы дать дополнительные попытки по другим задачам. В схеме статьи один запуск случайно выбирается для каждой задачи, затем второй достаётся случайному подмножеству. Результаты сначала усредняются внутри задачи, после чего задачи получают равный вес.
Если полное покрытие необязательно, оценщик может случайно опустить часть задач и направить освободившиеся выходы на дополнительные повторы в других. Тогда интервал учитывает не только скрытые запуски выбранных задач, но и вообще не проверенные задачи. Пропуск вопросов не даёт бесплатного роста точности. Цель остаётся средней по исходному набору, а невидимые задачи всё ещё входят в расчёт неопределённости.
В статье выведены нижние границы для обоих вариантов. Гарантия жёсткого бюджета ограничивает любого оценщика, включая политики, которые выбирают следующую задачу по предыдущим результатам. Экстремальная когорта может помещать решающее событие в конец каждого запуска. Неполный проход тогда почти ничего не сообщает. Скрытые расхождения допускают несколько фиксированных когорт, одинаково согласующихся с наблюдённой выборкой и имеющих разные суммарные оценки. Честный интервал должен покрыть обе возможности. Поэтому обещания при малом бюджете имеют предел.
В практических экспериментах интервал метода называется Joint. Он использует число расхождений в повторных парах для оценки ошибки балла и объединяет её с наблюдаемым средним. Затем интервал пересекается с логически возможными значениями по уже известным меткам. Дополнительные выходы на это не тратятся. Сравнивают метод с фиксированной равномерной базой, которая выбирает пары задача-запуск из полной сетки и использует точное распределение числа успехов.
Разрешение пропускать задачи зависит от цели оценки. Широкий публичный отчёт может требовать каждую категорию. Внутренний тест перед развёртыванием может выбирать задачи, отражающие клиентскую работу, и больше повторять каждую. Команде следует указать целевую совокупность, веса задач и возможность пропуска. Без этого более узкий интервал способен отвечать на вопрос, который организация не задавала.
Результат на LiveCodeBench получен при фиксированном бюджете#
Эмпирическое сравнение повторно использует уже зарегистрированные исходы LiveCodeBench. Для 16 модельных конфигураций авторы берут первые пять результатов «прошёл или не прошёл» по каждой из 880 задач программирования. Каждая конфигурация образует фиксированную когорту из 4 400 запланированных выходов. Сравнение проводят при 1 100 выходах и доверительном уровне 95 %. Полное покрытие означает один случайный выход по каждой задаче и второй запуск на случайно выбранных 220 задачах.
При равном числе выходов Joint дал более узкий средний интервал, чем равномерная выборка, в 15 конфигурациях из 16. Медианное сужение ширины составило 30,6 %. Результат относится к воспроизведённым конфигурациям и зафиксированным исходам при заданном протоколе. Он показывает значение информации о повторах в этом случае, но не обещает такого же снижения для каждого бенчмарка, модели или плана оценки. Детали replay LiveCodeBench
Единицей бюджета в эксперименте служит выход. Задачи LiveCodeBench имеют конечную метку прохождения или неудачи. В реальных запусках модели объёмы токенов, вызовов инструментов и времени различаются. Для сервиса, который одинаково оплачивает каждую попытку, число выходов лучше совпадает с фактической стоимостью. При больших различиях в длине задач компании потребуется отдельная схема для жёсткого предела расходов или другой расчёт стоимости переменных запусков.
Использование записанных исходов практично и прозрачно, но задаёт важное условие. 1 100 выходов выбираются из заранее накопленной сетки по пять запусков на каждую задачу. Replay сравнивает планы выборки на этой фиксированной когорте. Он не создаёт новых образцов будущего поведения модели. Другие версии, инструкции, задачи и условия запуска способны дать другую картину расхождений и ширины интервалов.
Авторы также исследуют контролируемое изменение согласованности внутри задачи и более длинные пути. Эти эксперименты помогают понять пользу повторов и связь длины исполнения с бюджетом. Эмпирические выводы остаются привязаны к заданным задачам, исходам и модельным конфигурациям. Теория помогает понять метод, после чего каждое применение следует рассматривать как отдельную задачу измерения.
Жёсткий бюджет отличается от управления средним расходом. Процесс, останавливающийся после первой успешной попытки, иногда позволяет выполнить больше простых задач при тех же средних затратах. Строгий предел должен выдерживать самый затратный набор исходов. Поэтому статья резервирует достаточно ресурсов, чтобы каждый выбранный запуск достиг максимальной длины. Гарантия касается верхней границы выходов или эпизодов, даже если некоторые пути заканчиваются раньше. Команде с оплатой через API имеет смысл отдельно считать длину ответов, повторы и вызовы инструментов. Их можно внести в схему после того, как станет известна связь с каждым запуском.
Схема оценки приобретает новое значение#
Для бенчмарка с повторными стохастическими попытками план должен заранее определять когорту. В неё входят версия модели, список задач, инструкции, настройки генерации, число попыток и правило успеха. Когорта задаёт оцениваемый объект, а выборка решает, какие наблюдения взять. Интервал описывает неопределённость средней оценки для этого плана, но автоматически не охватывает все будущие запросы и рабочие нагрузки.
Это особенно полезно для решения у порогового значения. Допустим, результат модели в тесте перед выпуском вырос с 79 до 81 %, а порог составляет 80 %. Среднее не объясняет, какую часть сдвига дали конкретные выбранные задачи и запуски. Если узкий интервал полностью лежит по одну сторону порога, это может поддержать решение. Широкий интервал может стать основанием для дополнительных тестов. Метод распределяет фиксированное число выходов с учётом наблюдаемой согласованности в задачах, помогая уточнить оценку.
Команды могут использовать повторение и для диагностики теста. Задачи с частыми расхождениями могут быть более стохастичными, чувствительными к запросам или условиям выполнения. Повторы делают вариативность заметной. Согласованные результаты дают другой тип данных. Сама схема не определяет источник расхождений. Журналы, проверка запросов и разбор неудач нужны, чтобы отличить рассуждение модели от сбоя инструмента, недетерминированных данных или нестабильного оценщика.
Разрешение пропусков связано и с решением о продукте. Публичный широкий отчёт может требовать каждую категорию. Внутренний запуск может сосредоточиться на клиентах, оценивать заранее заданный взвешенный результат и выбирать задачи согласно их работе. Если веса неравные, схема выборки тоже должна их учитывать. Доказательства статьи задают точную цель и помогают понять, когда для собственного взвешивания нужно адаптировать интервал.
Гарантия покрытия зависит от выбранного плана. Audit, Joint, фиксированная равномерная выборка и адаптивные стратегии имеют разные свойства. Не следует напрямую переносить эмпирическое сужение 30,6 % на собственный набор. Команда может реализовать конкретный дизайн, задать цель и доверительный уровень и проверить расчёт интервала. Статья предоставляет теорию для исследованных методов и условия экспериментального replay.
Что устанавливает результат#
Статья предлагает схему выборки для повторных бинарных исходов при строгом бюджете выходов. Она использует расхождения по задаче, строит честный доверительный интервал, доказывает ограничения с полным покрытием и с разрешёнными пропусками, затем проверяет подход на исторических данных LiveCodeBench. При том же номинальном бюджете интервалы стали уже у большинства тестовых конфигураций, медианное снижение ширины составило 30,6 %.
Результат касается точности оценки. Средний балл модели и неопределённость вокруг него связаны, но отвечают на разные вопросы. Повторные попытки выявляют вариацию, скрытую при одном запуске. Метод формализует, как эти наблюдения могут улучшить интервал, сохраняя покрытие для заранее определённого набора плановых исходов.
Главная граница касается понимания стоимости. Предел по числу выходов легко повторить на двоичной задаче программирования. Доллары, токены и реальное время не взаимозаменяемы для разных рабочих нагрузок. Внешнее применение тоже ограничено. 16 конфигураций и историческая когорта по пять результатов на задачу подтверждают данный replay, а будущие модели и бенчмарки могут вести себя по-другому. Команда может взять дизайн за основу, если явно задаст свою когорту, единицу стоимости и требования к задачам.
Надёжное сравнение модели зависит и от оценки, и от плана выборки, который её поддерживает. Эта статья ставит план в центр процесса. Практическая идея состоит в том, что повторы части задач показывают расхождение исходов и помогают оценить влияние невиденных запусков на итог. Replay LiveCodeBench даёт пример улучшения точности при фиксированном числе выходов. Другие тесты покажут, как выгода меняется с задачами, результатами и эксплуатационными затратами.