Lorsqu’un agent lit un document dense, il commence souvent par une vue basse résolution puis consacre un nombre limité de recadrages haute résolution aux zones importantes. La valeur d’une zone dépend en partie de ce qu’elle permet de faire ensuite. Avec deux lectures restantes, un champ d’orientation peut indiquer le bon tableau. Avec une lecture, ce même champ consomme la dernière occasion sans montrer la réponse. Un article publié le 18 novembre propose un protocole pour vérifier si les agents visuels tiennent compte de ce budget changeant. Il conserve les preuves publiques et les correspondances des régions, tout en changeant le nombre de lectures ou la valeur d’une action. Audit visuel par budgets appariés
La méthode suit aussi les conséquences de chaque observation dans un historique complet. Sous un modèle explicite du document et de l’outil de lecture, elle calcule la meilleure continuation possible après chaque historique. L’écart entre cette valeur et celle de la zone choisie par l’agent forme une perte d’acquisition par étape. Une mesure terminale distincte évalue la réponse une fois l’observation arrêtée. Cette comptabilité permet de localiser les pertes d’exactitude dans le modèle étudié.
Les auteurs appliquent le protocole à des tâches contrôlées de routage, à des hiérarchies à plusieurs étapes et à trente formulaires numérisés du jeu FUNSD. Un résultat pratique ressort. Le premier choix d’un modèle peut sembler raisonnable, alors que sa politique reste figée lorsque le budget restant ou la valeur d’une région change. Sur les formulaires, les gains apparents du recadrage dépendent des réponses de référence, et les parcours multi-crops peuvent faire moins bien que la lecture de l’image entière malgré un plus grand nombre de tokens.
Une première zone peut guider la suivante#
La tâche contrôlée utilise cinq régions d’un document. Il y a un sélecteur, deux branches de réponse possibles et deux zones leurres. Une correspondance publique indique le rôle de chaque région physique. La règle de la question établit comment les bits cachés déterminent la réponse. Chaque lecture renvoie une valeur selon un canal d’observation déclaré. Pour ces cas contrôlés, l’évaluateur connaît le prior et le canal, ce qui permet de calculer exactement l’exactitude espérée de chaque séquence légale.
Dans la tâche switch, le sélecteur indique quelle branche contient la réponse utile. Avec deux lectures restantes, il est optimal de regarder le sélecteur en premier car il dirige le second crop vers la branche active. Avec une seule lecture, l’ouverture directe d’une branche donne la réponse. Le sélecteur n’a plus le temps d’orienter une seconde observation. Le meilleur premier choix change donc avec le budget.
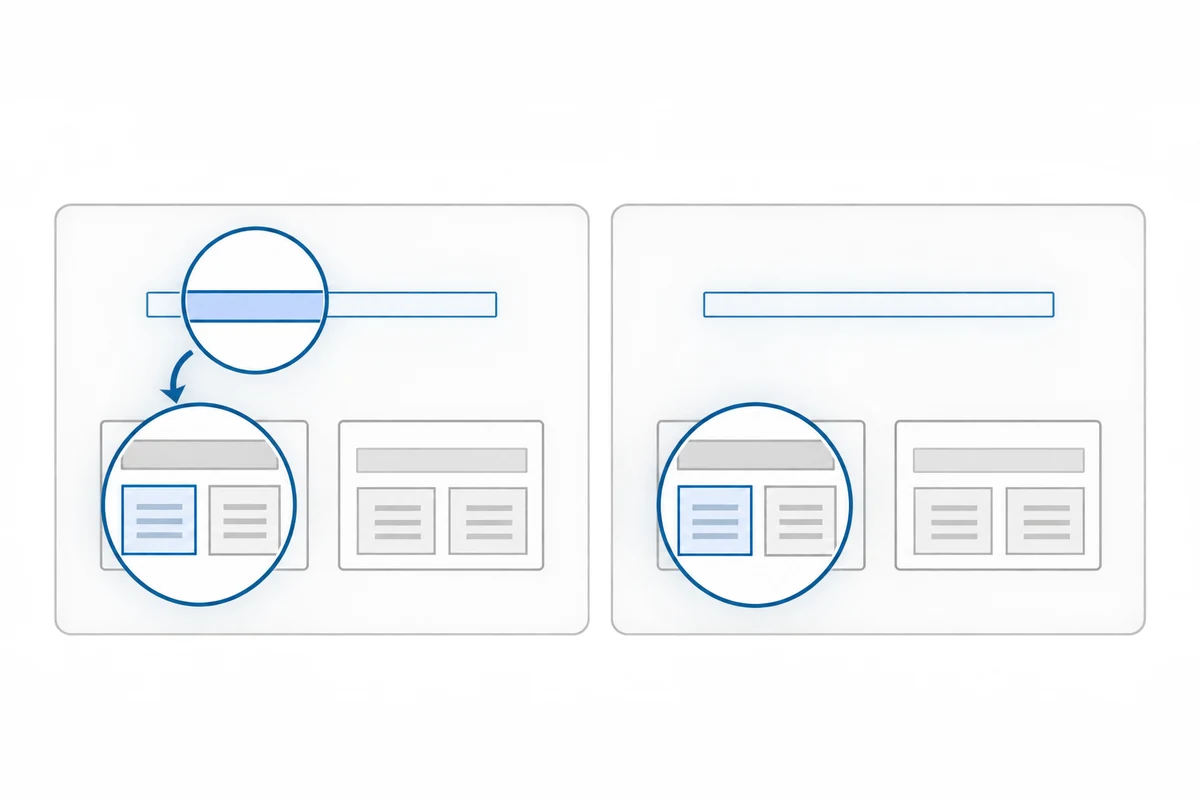
L’article construit des paires où les preuves publiques et les correspondances entre régions restent identiques. Seul le budget restant change, ou un paramètre qui détermine la valeur de l’action. Une préférence fixe pour le sélecteur peut sembler juste avec deux lectures. Le cas apparié à une lecture vérifie si la politique s’adapte à l’horizon. La paire distingue deux explications que l’exactitude sur des cas isolés ne permet pas de départager. Le modèle peut comprendre le rôle du sélecteur tout en ignorant le budget restant.
La même idée déplace la frontière de valeur. Une branche peut devenir plus informative lorsque le prior de réponse change ou que la fiabilité du sélecteur diminue. L’expérience fait bouger cette frontière tout en gardant le reste du scénario. Une politique qui ouvre toujours le sélecteur peut être utile près d’un réglage, puis le choisir trop souvent lorsqu’une branche directe a plus de valeur. Une politique sensible à la valeur de la tâche devrait changer de choix lorsque les valeurs de continuation se croisent.
Le test dépend d’un modèle explicite de la tâche. L’article déclare le prior sur les états cachés du document et la distribution des retours de lecture, puis énumère les résultats possibles. Les conclusions décrivent les décisions optimales selon ces hypothèses, qui délimitent aussi leur interprétation. Un document réel peut comporter des correspondances incertaines, du bruit OCR ou des erreurs corrélées entre champs. Ces facteurs peuvent différer du modèle contrôlé et demandent des modèles de lecture mesurés ou des audits supplémentaires.
L’exactitude seule cache le parcours#
Un test de question-réponse isolé enregistre si la réponse finale est juste. Il ne montre pas quelle région l’agent a lue, si ce choix avait de la valeur à cet instant ou si sa politique a changé après la réponse de l’outil. L’article calcule la valeur de continuation pour chaque historique d’observation. Budget restant, historique et modèle déclaré déterminent ensemble l’action capable de préserver la meilleure exactitude finale espérée.
Pour chaque région consultée, l’audit consigne la meilleure continuation possible et la valeur du choix réellement fait par l’agent. Leur différence mesure la perte d’acquisition. Une fois le budget épuisé, l’évaluateur calcule la meilleure réponse permise par les preuves recueillies. L’écart entre cette réponse et celle du modèle devient la perte de décision terminale. L’addition des deux termes décompose l’écart d’exactitude espéré entre la politique optimale et la politique observée sur toute la trajectoire.
Cette décomposition sépare deux types de problèmes. L’agent peut rassembler des preuves faibles en lisant des régions de peu de valeur. Il peut aussi obtenir des preuves utiles puis répondre incorrectement. Le taux d’erreur final mélange ces cas. La trace les distingue selon le prior et le canal de lecture déclarés par l’évaluateur tout en conservant l’historique créé par les choix du modèle.
L’article donne un exemple concret. Avec deux lectures restantes, le sélecteur est optimal car il oriente vers la bonne branche. Si l’agent l’ouvre et reçoit une valeur activant une porte, il devrait regarder cette porte ensuite. Dans une trajectoire Qwen3-VL-8B enregistrée, le modèle ouvre plutôt un leurre. Cette action coûte 25 points de valeur conditionnelle dans la tâche construite. Il lit ensuite une autre feuille et ne consulte pas la porte. Le postérieur peut rester indécis. La réponse finale peut donc contredire la réponse archivée alors que la perte de décision terminale est nulle par rapport à la meilleure décision du modèle. L’audit attribue la perte au choix d’observation.
La meilleure exactitude conditionnelle au postérieur et l’exactitude observée doivent aussi être distinguées. Si les preuves donnent la même probabilité aux deux réponses, chacune a une perte de décision nulle par rapport au meilleur choix possible, mais l’exactitude maximale ne dépasse pas 50 %. Un agent peut prendre la meilleure décision finale alors que les preuves restent insuffisantes. L’audit rapporte séparément la suffisance de l’information et la qualité de la décision. Cela aide lorsque l’évaluation porte à la fois sur la politique d’observation et sur la réponse.
Les paires révèlent une préférence persistante pour le sélecteur#
L’étude teste cinq modèles vision-langage ouverts sur quarante paires de routage chacun. Avec des priors équitables et des lectures sans bruit, la branche est optimale lorsqu’il reste une lecture, et le sélecteur lorsqu’il en reste deux. Dans les ancres de forte valeur, le meilleur choix sous-optimal perd 25 points. Aucun des cinq modèles n’effectue la transition optimale branche-vers-sélecteur dans ses quarante paires.
Plusieurs choisissent le sélecteur dans chaque condition appariée. Qwen3-VL-32B le sélectionne pour toutes ses 2 320 requêtes d’acquisition de confirmation. D’autres répartissent certaines décisions sur les branches ou les leurres, sans produire de transition correcte dans les quarante ancres. Leur perte moyenne sur ces cas construits pour être discriminants va de 12,50 à 15,62 points de pourcentage. Dans des exemples moins proches de la frontière, elle est seulement de 0,59 à 0,85 point. Une moyenne basse sur des cas peu diagnostiques peut cacher une politique rigide. La paire contrefactuelle met cette limite sous pression.
Ce comportement peut toutefois changer. GPT-5 mini, modèle hébergé, fait le switch optimal sur 48 paires sur 48 avec une image et une carte, et sur 47 sur 48 avec la carte seule. GPT-4.1 réussit 44 sur 48 en mode carte seule. Son protocole image-carte conserve la préférence pour le sélecteur, sans transition. Ces modèles hébergés utilisent leurs propres versions datées et protocoles. Ils montrent qu’une décision sensible au budget est possible dans la tâche, pas une comparaison directe contrôlée avec les modèles ouverts.
L’article déplace aussi la frontière de valeur en modifiant les priors et la fiabilité du sélecteur. À une fiabilité de 0,74, quatre profils produisent des avantages différents, deux favorables à une branche et deux au sélecteur. GPT-4.1 sélectionne le sélecteur dans les 864 décisions. GPT-5 mini à faible effort fait plusieurs choix optimaux, mais garde la même préférence dans la majorité des familles de chaque profil. Sur les familles laissées à part pour la prédiction, la fiabilité seule prédit ses choix mieux que l’avantage signé de l’action.
Le résultat décrit le comportement des politiques dans le modèle précis testé. Les auteurs n’en concluent pas qu’un modèle ignore totalement le budget ou la structure du document. Une règle simple donnant priorité au sélecteur peut être efficace dans nombre de situations courantes. Les paires servent à distinguer cette habitude fixe d’une politique qui réagit au nombre de lectures restantes et à la valeur de l’action. Cette différence devient importante sous un budget strict de crops.
La perte augmente après la première lecture#
Les auteurs étendent les tâches contrôlées à une hiérarchie de huit régions. Une racine mène à l’une de deux portes, chacune ouvrant sur l’une de quatre feuilles de réponse, avec un distracteur. L’agent dispose de trois lectures. Une bonne première zone doit donc être suivie de choix utiles au regard des réponses obtenues.
Sur 160 trajectoires par checkpoint, la perte de première lecture est faible, entre 0,18 et 0,96 point. La perte cumulée des deuxième et troisième lectures va de 22,20 à 26,76 points. La décision terminale ajoute entre 5,73 et 14,30 points. L’exactitude observée s’établit entre 53,75 et 57,50 %. La majorité de la perte mesurée apparaît après la première observation, lorsque l’agent doit sélectionner la zone suivante en fonction des nouvelles preuves.
La tendance persiste dans le profil équilibré sans bruit. La perte de première lecture reste entre zéro et 3,12 points. Celle des lectures suivantes atteint 29,38 à 36,88 points. Un contrôle où toutes les premières actions légales ont la même valeur conserve une perte mesurable par la suite. Ces résultats désignent la politique de continuation comme le principal problème dans les hiérarchies testées. Une décision ponctuelle peut sembler bonne tandis que la trajectoire complète reste nettement en dessous de sa référence exacte.
Les valeurs exactes de l’évaluateur dépendent du modèle de tâche. Dans les expériences contrôlées, liaisons de régions, priors et canaux de lecture sont définis. L’évaluateur peut énumérer les états. Dans des scènes ouvertes, les priors et modèles d’observation devront être appris ou approximés. Une erreur dans ces valeurs modifie l’attribution des pertes. Les auteurs le signalent comme une limite. Le calcul est exact relativement au modèle déclaré, lequel peut simplifier un flux documentaire réel.
Les références de tâche définissent aussi ce qui compte comme utile. Si l’étiquette du sélecteur est bruitée ou si les régions sont mal reliées, la route théoriquement optimale sur une carte fournie peut ne pas être la meilleure dans un système de numérisation réel. Les tâches contrôlées utilisent des liaisons vérifiées afin d’isoler le choix. Un test de production devra aussi évaluer la localisation et la qualité de lecture, car le bon rôle ne sert à rien si le crop exclut le texte.
Les formulaires réels changent selon le corrigé#
Le panneau documentaire naturel utilise 30 pages de formulaires scannés FUNSD. Chaque page comprend une vue basse résolution et six crops haute résolution dans une grille fixe de trois colonnes et deux lignes. L’étude compare le choix d’un crop à un lecteur uniforme partagé. Elle compare aussi une politique séquentielle de deux crops à une lecture native de l’image complète, réalisée en un appel. Deux définitions de référence sont utilisées : les étiquettes originales et une version retravaillée par les auteurs.
Avec la référence retravaillée, Qwen3-VL-8B répond correctement à 24 des 30 pages après sélection d’un crop, soit un gain de 24,44 points sur le lecteur uniforme. Avec le texte de référence original, les mêmes décisions enregistrées ne gagnent que 10,56 points, et l’intervalle traverse zéro. La formulation du corrigé change ce qui est considéré exact. Par exemple, une référence originale combine deux champs voisins. Retirer le texte adjacent du corrigé révisé transforme une réponse enregistrée, auparavant fausse, en bonne réponse.
La procédure complète à deux crops ne dépasse pas la lecture native de page entière dans ce panneau. Qwen3-VL-8B répond correctement à 21 pages sur 30 avec deux crops, contre 25 en vision intégrale. La procédure à crops utilise trois appels et environ 1 662,8 tokens d’entrée par page. La lecture native prend un appel et 824,8 tokens. InternVL3.5-8B répond également à moins de pages avec les crops qu’avec l’image entière. Une observation supplémentaire n’augmente pas nécessairement l’exactitude.
La définition du score rend le gain apparent plus incertain. Sur les mêmes sorties enregistrées, l’étude croise texte de référence original ou révisé avec deux règles de normalisation. Pour Qwen3-VL-8B, le texte révisé seul augmente le gain du choix de crop de 12,22 points. La normalisation de ponctuation seule l’augmente de 10 points. Leur interaction réduit le changement combiné de 8,33 points. Le résultat souligne que références textuelles et normalisation doivent être publiées lorsqu’on évalue une correspondance exacte.
Les résultats sur formulaires sont limités et sensibles au corrigé. Plusieurs intervalles de comparaison traversent zéro. Les auteurs n’en déduisent pas que le crop améliore généralement la compréhension documentaire. Les références ont été préparées avec une assistance IA sans arbitrage humain indépendant. Les pages FUNSD sont publiques et ont pu figurer dans les données de préentraînement. Ce volet sert autant d’audit du protocole d’évaluation que de comparaison de politiques d’observation.
Ce que le protocole peut soutenir#
Les audits par budgets appariés distinguent deux politiques qui choisissent le même crop pour un budget, mais devraient diverger lorsque le nombre de lectures change. Les valeurs de continuation exactes quantifient le coût d’une observation dans les tâches contrôlées. Le compte rendu de trajectoire montre si la précision est perdue lors de l’acquisition ou dans la réponse finale. Le protocole permet ainsi d’évaluer une séquence d’observation, et pas seulement l’exactitude terminale.
La méthode exige un prior déclaré sur la scène cachée, un modèle des retours de lecture et des liaisons vérifiées entre rôles des tâches et zones physiques afin de calculer les valeurs exactes. Les expériences contrôlées reposent sur ces hypothèses. Le volet des formulaires naturels utilise l’exactitude empirique sans prétendre à un modèle de postérieur exact. Les documents ouverts introduisent une localisation incertaine, du bruit OCR et des erreurs corrélées entre champs. Étendre le calcul exact nécessiterait un modèle d’observation dont l’erreur peut elle-même être mesurée.
La couverture de modèles est limitée. Les cinq systèmes ouverts partagent des composants linguistiques dérivés de Qwen. Ils traitent des états textuels structurés avec un décodage contraint et sans phase de raisonnement explicite. Les deux modèles hébergés emploient des endpoints datés et leurs propres protocoles. Ils démontrent que le comportement souhaité est possible, sans constituer une comparaison directe. D’autres familles, le raisonnement libre et des canaux visuels appris restent à tester.
Les preuves principales soutiennent une affirmation précise. Dans les tâches contrôlées rapportées, les modèles ouverts continuent souvent à consulter un sélecteur fixe alors qu’une paire de budgets rend une branche plus utile. Dans les hiérarchies plus longues, l’essentiel de la perte au regard du modèle exact survient après la première lecture. Sur les formulaires numérisés, le gain dépend du corrigé et les crops doivent être comparés à l’image entière et au coût des tokens. Ces observations restent bornées par les tâches et les modèles étudiés.
Les panneaux contrôlés séparent aussi la politique de l’interface d’observation. L’audit de routage fournit une carte des rôles et des retours structurés. Cela facilite le test de la décision après observation, mais laisse de côté la localisation et la qualité du crop. Le panneau naturel réintroduit images et recadrages avec d’autres incertitudes. Le modèle peut viser le bon champ et manquer son texte. Il peut aussi le lire mais interpréter de travers une étiquette ambiguë. Il faut des contrôles distincts pour attribuer ces échecs.
Le repère exact de l’article dénombre les valeurs de continuation sous un modèle probabiliste déclaré. À partir de l’historique, du budget et de la distribution des lectures, l’évaluateur calcule la valeur d’une action. Cela convient aux tâches synthétiques, où tous les états et retours peuvent être énumérés. Pour les formulaires réels, les états cachés et canaux d’observation ne sont pas connus exactement. Les auteurs utilisent donc l’exactitude empirique et les comparaisons par page, sans revendiquer la même garantie de postérieur exact pour les documents.
Cette différence entre les panneaux compte pour l’interprétation. Les tâches contrôlées fixent les preuves publiques et les associations pendant que le budget ou la valeur change. Les formulaires réels montrent si les crops aident sur un petit ensemble de documents, mais ne donnent pas une valeur exacte à chaque crop, car les réponses de référence et le modèle de lecture comportent eux-mêmes une incertitude. Les deux volets répondent à des questions différentes.
Le déploiement demande une trajectoire complète#
Pour un agent documentaire déployé, chaque crop a un coût marginal. Il peut ajouter des tokens, des appels, de la latence et un risque de mauvaise lecture. Une évaluation avec un nombre illimité de lectures ne montre pas si la politique reste efficace sous une limite fixe. Un test à un seul budget ne révèle pas si l’agent change de stratégie quand il lui reste moins de lectures. Le protocole apparié expose cette sensibilité dans des conditions contrôlées.
L’audit de la trajectoire complète pose la question opérationnelle. Depuis la vue initiale et un budget fixé, quels choix sont faits après chaque retour et quelle réponse sort à la fin ? La perte d’acquisition par étape peut signaler une zone qui n’a pas apporté assez de valeur attendue. La perte de décision terminale peut révéler une difficulté à combiner les preuves réunies. Les publier à côté de l’exactitude finale rend l’échec plus exploitable et facilite la comparaison des interfaces et politiques.
Un tel test crédible demande plusieurs définitions. L’évaluateur doit préciser les zones légales, la génération ou la lecture des retours, la règle de réponse et la mesure du budget restant. Pour les documents naturels, il faut également vérifier les réponses de référence, consigner le prétraitement et aligner les conditions du lecteur d’image entière. Une procédure de crops doit publier ses appels supplémentaires et sa surface d’image traitée, pas seulement son exactitude. Ce travail rend les conclusions plus vérifiables.
Les modèles ouverts étudiés emploient des formats de sortie contraints et ne disposent pas d’une phase de raisonnement explicite. En production, encodeur visuel, politique d’outils, cache, génération des régions ou raisonnement caché peuvent différer. Ces éléments changent le coût et la valeur de chaque observation. Un nouveau déploiement doit évaluer sa configuration complète. La comparaison actuelle diagnostique des politiques spécifiées, elle ne classe pas universellement les agents visuels.
Pour les équipes produit, la leçon est d’évaluer la politique d’observation complète. Il faut tester la région lue, l’usage de la réponse obtenue, le changement de stratégie quand le budget se réduit et la fiabilité de la réponse finale. Texte de référence, définition des crops, baseline image entière et coût des entrées doivent être transparents. Un simple score de réponse ne révèle pas le parcours qui l’a produit.
L’article offre un protocole détaillé pour diagnostiquer ce parcours dans des contextes contrôlés. Son résultat le plus marquant n’est pas un gain d’exactitude, mais l’écart entre une première action plausible et une politique séquentielle efficace. Le premier crop peut être bien choisi. Les décisions suivantes peuvent ignorer les informations déjà reçues et consommer le budget restant. Mesurer chaque étape permet de repérer cette perte avant de déployer un agent visuel dans un travail documentaire où chaque lecture est payante.