Deux chercheurs ont présenté RFBench le 17 novembre pour tester des modèles multimodaux sur les circuits radiofréquences passifs. Chacun des 10 000 layouts à deux ports possède plusieurs représentations. Un modèle peut recevoir une spécification, une image rendue ou des primitives géométriques éditables, puis générer un layout, traduire une représentation, prédire une réponse ou diagnostiquer une conception. La réponse provient d’une simulation électromagnétique. L’enseignement principal de l’article est que ces étapes sont liées sans être équivalentes. Article RFBench
Les structures RF passives guident ou façonnent des signaux haute fréquence sans amplification active. Lignes de transmission, réseaux d’adaptation d’impédance, filtres et circuits d’accord d’antenne dépendent tous de la disposition du métal conducteur. Un léger changement de largeur, d’écart, de connexion ou de position des ports peut modifier la réflexion et la transmission selon la fréquence. Les ingénieurs passent donc continuellement d’une cible de performance à un layout éditable puis à une simulation électromagnétique complète. Un tracé peut paraître ordonné tout en restant électriquement déconnecté ou en ratant la réponse voulue.
Cette difficulté motive un benchmark reliant langage, géométrie et physique. Un modèle multimodal peut reconnaître une image familière ou produire une liste de rectangles bien formatée. La conception RF demande aussi que les rectangles forment une structure valide, que sa géométrie corresponde à la représentation visée et que son comportement électromagnétique respecte la spécification. Chacune de ces affirmations nécessite son test. RFBench les répartit entre sept familles de tâches sans laisser une métrique facile tenir lieu de processus complet.
Un layout, plusieurs représentations liées#
Le jeu de données contient 10 000 layouts passifs planaires à deux ports produits par génération procédurale. Chaque dessin accepté associe des rectangles et ports éditables, une image rendue, une grille d’occupation de 16 × 16 cellules, une matrice de paramètres S complexe simulée, une classe structurelle et une étiquette de réponse. Un identifiant partagé lie ces représentations. Le benchmark peut ainsi vérifier si un modèle conserve la même géométrie métallique en passant d’une description symbolique à une image et à une grille discrète.
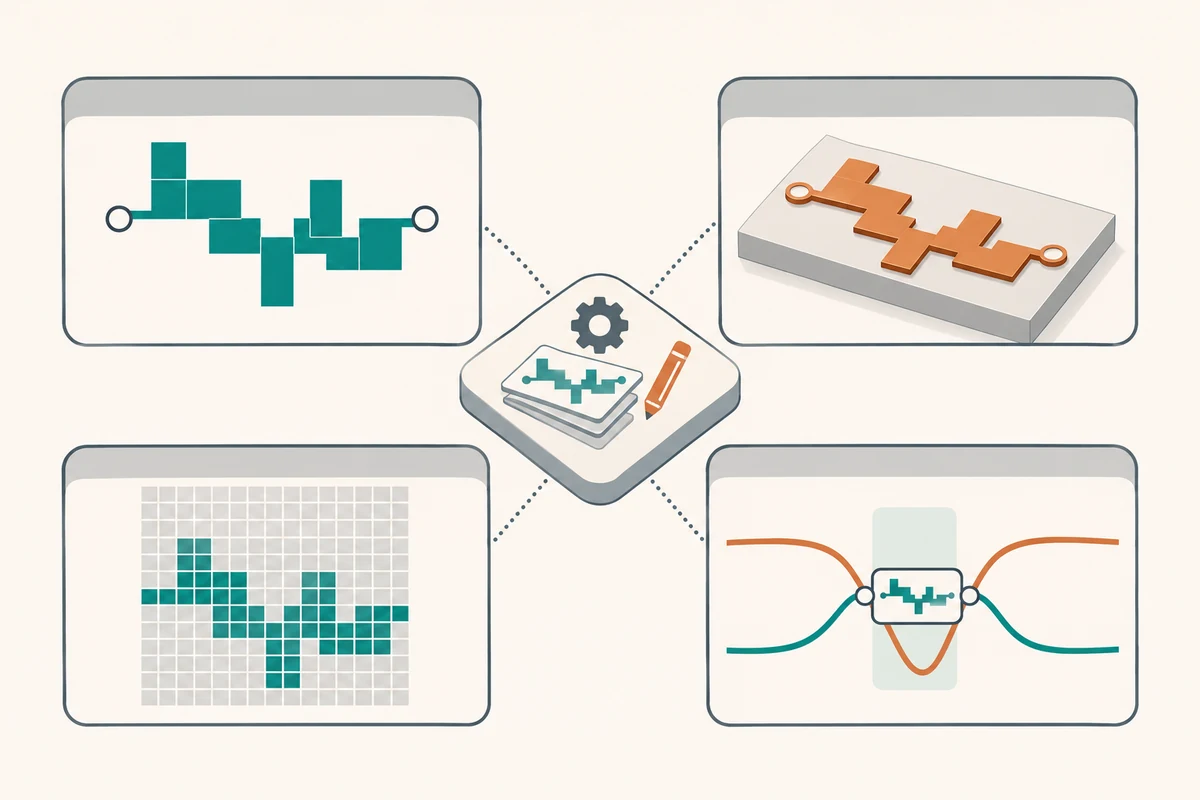
Les cinq catégories structurelles comptent chacune 2 000 exemples. Elles comprennent des layouts aléatoires connectés, des pistes centrales inspirées du microstrip avec branches, une symétrie de rotation à 180 degrés et des symétries miroir gauche-droite ou haut-bas. Il s’agit de familles de construction contrôlées, pas d’échantillons de tous les layouts des produits RF. Elles offrent des exemples reproductibles de connectivité, de symétrie et de motifs géométriques contrôlables automatiquement.
Chaque layout est simulé avec ADS Momentum sur 201 fréquences espacées régulièrement entre 1 et 10 GHz. Les données conservent la matrice de diffusion complexe complète, de dimensions 2 × 2. Ces valeurs décrivent les réflexions et transmissions entre ports selon la fréquence. En ingénierie, le comportement de la courbe entière compte. Le benchmark peut donc comparer chaque point prédit et vérifier la passivité, la réciprocité et d’autres propriétés physiques en plus de l’erreur numérique classique. Données et détails de simulation
Le dataset est généré, il ne provient pas de mesures sur des cartes fabriquées. Des générateurs de géométrie produisent des candidats, puis des contrôles automatiques rejettent les layouts qui ne satisfont pas les contraintes, par exemple la connectivité, les limites du canvas ou les ports. Les cinq familles sont équilibrées dans le corpus retenu. Les étiquettes de réponse ne le sont pas toutes. Certaines classes sont rares. Le classifieur de réponse rapporte donc un macro-F1 équilibré par classe en plus de l’exactitude, ce qui limite le poids des classes les plus courantes.
La séparation officielle réserve 9 000 conceptions au pool d’entraînement et 1 000 à l’évaluation commune. Les exemples retenus comprennent 200 éléments de chacune des cinq familles. T1, T2, T3, T6 et T7 utilisent ces mêmes identifiants, ce qui facilite les comparaisons appariées. L’exécution du simulateur utilise un sous-ensemble équilibré de 250 layouts générés et le diagnostic s’appuie sur 100 cas partagés. Il s’agit de panneaux d’évaluation différents. Les résultats principaux ne reposent pas tous sur l’intégralité du corpus.
L’alignement des représentations rend le diagnostic des échecs plus instructif. Si un modèle transforme des rectangles éditables en grille incorrecte, le résultat révèle un problème de conversion symbolique. S’il traite bien les primitives mais mal l’image, l’écart suggère une faiblesse de perception visuelle. Si les deux traductions fonctionnent mais que la prédiction de réponse échoue, le défaut se situe ailleurs. Un score unique brouillerait ces causes. RFBench conserve les tâches intermédiaires pour repérer l’étape où le flux d’ingénierie commence à échouer.
Sept tâches suivent un flux de conception#
La première famille demande la génération d’un layout à partir d’une spécification électrique en langage naturel. Dans une version, le modèle reçoit les magnitudes visées de quatre paramètres S à trois repères fréquentiels. Dans l’autre, il doit aussi respecter une catégorie structurelle. La sortie est une géométrie éditable. Le score de validité vérifie les deux ports, l’inscription dans le canvas et un chemin métallique connecté entre les alimentations. La conformité de catégorie est évaluée à part lorsqu’une catégorie est demandée.
Les valeurs cibles proviennent d’une conception simulée, donc une géométrie connue peut répondre à chaque spécification. Le layout original est caché et le modèle n’a pas à retrouver exactement cette géométrie. Il peut satisfaire la même cible avec une autre configuration valide. C’est important pour un test de conception générative qui évalue le comportement électrique demandé et les règles structurelles, plutôt que la capacité à deviner un layout source. Trois repères fréquentiels condensent la spécification montrée au modèle. La vérification ultérieure contrôle le balayage complet et sépare ainsi l’instruction courte de la validation sur chaque fréquence.
La deuxième famille porte sur la traduction des représentations. Le modèle convertit la géométrie éditable en grille binaire d’occupation métallique ou transforme une image rendue dans cette même grille. La grille de 16 × 16 contient 256 cellules. Précision, rappel, F1 de la zone occupée et intersection-sur-union évaluent l’exactitude du métal. L’article fournit aussi le taux d’accord exact et la distance de Hamming normalisée. Cette tâche isole la préservation de la forme pendant le changement de représentation.
La troisième famille prédit la réponse électromagnétique. Le modèle reçoit des primitives ou une image et prédit le balayage de paramètres S complexes sur 201 fréquences. Les métriques comprennent la MAE complexe, la part de points matrice-fréquence situés dans 2 dB, le taux de passivité, l’erreur de réciprocité et l’erreur de dérivée spectrale. Ces métriques décrivent des propriétés différentes. La proximité point par point peut laisser passer une courbe physiquement incorrecte. Définitions des tâches RFBench
La quatrième famille exécute un layout généré dans ADS Momentum. Une géométrie syntaxiquement valide peut échouer lors de l’importation dans le simulateur, donc le taux de lancement est mesuré. Après une simulation complète, le test vérifie que les douze magnitudes aux trois fréquences cibles se trouvent toutes dans une tolérance de 3 dB. Un layout peut donc s’exécuter sans respecter la cible électrique. Les deux mesures distinctes montrent cette différence.
Le diagnostic et l’amélioration constituent la cinquième tâche. Le modèle reçoit un layout, sa réponse simulée et une spécification cible. Il décide si des modifications sont requises et propose, si nécessaire, un nouveau layout. Précision, rappel, accuracy et macro-F1 évaluent la décision, puis les modifications sont simulées séparément. La réduction d’erreur et l’amélioration de bout en bout incluent les layouts invalides et simulations manquantes. Le diagnostic doit être correct, mais la géométrie modifiée doit également améliorer le résultat physique.
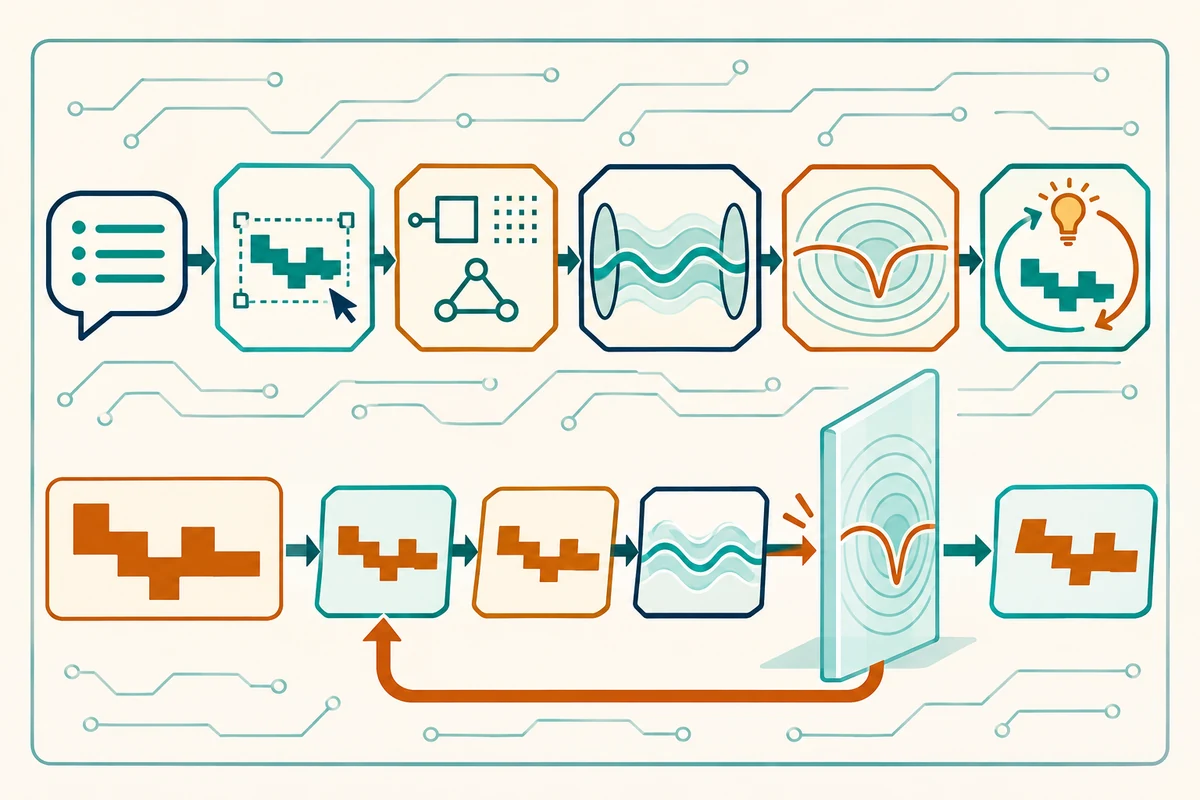
La compréhension structurelle et la classification de réponse complètent la suite. Une tâche identifie la catégorie du layout à partir de primitives ou d’une image, ainsi que des drapeaux pour symétrie et connectivité. Une autre classe la réponse simulée en catégories traversantes larges bandes, atténuantes, passe-bas, passe-bande, coupe-bande ou résonantes et façonnées. Ces tâches demandent au modèle de reconnaître des propriétés du tracé et de son résultat. Elles ne remplacent toujours pas la génération d’une conception complète.
Les auteurs ne prennent pas un score agrégé comme classement principal. Les sorties, métriques et significations physiques diffèrent selon les tâches. Un score unique imposerait des choix de pondération et de compromis. Il vaut mieux lire un profil. Un modèle peut traduire les tracés de façon fiable tout en prédisant une réponse erronée. Un autre peut classifier les réponses, mais ne pas produire une conception connectée. Les résultats séparés aident à choisir l’étape du processus de conception à laquelle un modèle pourrait servir.
La validité géométrique n’est que la première étape#
Les modèles non adaptés génèrent souvent des formes plausibles qui échouent aux contrôles structurels combinés. Certains placent presque toujours les marqueurs des deux ports, mais tous les modèles de base obtiennent une validité structurelle de 0 % dans la génération conditionnée par spécification. Il faut réunir ports, canvas et chemin métallique connecté. Un résultat qui passe un parseur ou possède deux extrémités ne constitue pas encore un layout RF utilisable.
Le fine-tuning RF spécifique change fortement ce résultat pour Qwen3-VL-8B. Le fine-tuning supervisé atteint 82,7 % de validité structurelle dans une tâche de génération et 86,0 % dans la tâche sous contrainte de catégorie. L’étape GRPO atteint ensuite 83,2 % et 86,4 %. La conformité complète à la catégorie est de 85,7 % et 85,2 %. Ces résultats montrent que des exemples et une adaptation au domaine apprennent au modèle à respecter le contrat de sortie géométrique. Ils évaluent la structure, pas la réponse RF finale.
Le test fermé par simulation met en évidence l’étape suivante. Les deux modèles adaptés obtiennent un taux d’exécution ADS de 100 % sur 250 layouts générés. Seulement 1,6 % des sorties SFT et 2,8 % des sorties GRPO respectent la condition stricte qui exige que les douze magnitudes cibles restent dans 3 dB. Cet écart est instructif. La géométrie peut satisfaire une règle structurelle et fonctionner dans un simulateur industriel, tout en ratant la cible électrique. La conception RF inverse reste bien plus difficile que la production de cuivre syntaxiquement et structurellement valide.
Cette différence compte pour les affirmations d’automatisation industrielle. Un layout qui s’exécute dans ADS franchit une étape d’exécution. Il ne constitue pas forcément un filtre, réseau d’adaptation ou dispositif d’accord d’antenne aux performances promises. La cible décrit un comportement électrique sur une plage de fréquences. La forme générale peut convenir alors que réflexion, transmission ou bande passante restent hors cible. Un rapport rigoureux sépare taux d’exécution et réussite de la spécification.
Les spécifications cibles proviennent de layouts simulés, donc au moins une géométrie source les réalise. La reproduction exacte n’est pas demandée. Cela produit un problème de conception inverse contrôlé, mais l’évaluation reste liée à l’espace de conception représenté par le générateur et le simulateur. La fabrication ajoute matériaux, tolérances, packaging, connecteurs et conditions de mesure, autant d’éléments absents des tâches présentes.
Des formes proches peuvent avoir des physiques différentes#
La tâche de traduction est celle qui profite le plus de l’adaptation. Les meilleurs modèles non adaptés atteignent un F1 de zone occupée de 31,4 % à partir des primitives et 48,2 % à partir des images. Aucun n’obtient une grille exactement identique. Après entraînement RF spécialisé, les variantes Qwen3 dépassent 99,97 % de F1 pour les deux entrées, avec 99,0 à 99,5 % d’accord exact. Le résultat est presque saturé sur le problème de traduction discrète du benchmark.
Cette réussite a du sens, mais elle mesure la récupération d’une grille d’occupation de 16 × 16 cellules. Elle ne prouve pas que le modèle comprend toutes les conséquences électriques de la forme métallique. Le pool d’entraînement et le test reposent sur les mêmes familles procédurales. Les nouvelles conceptions retenues testent la généralisation au sein du corpus généré. Le transfert à des tracés hors générateur et aux conditions de fabrication reste une question ouverte.
La prédiction de réponse demeure plus difficile. Parmi les modèles non adaptés, Claude 4.5 est le plus équilibré, avec 28,0 % des points matrice-fréquence dans 2 dB pour les primitives et 27,0 % pour les images. Qwen3 SFT fait passer ces taux à 62,6 et 64,1 %. GRPO les modifie légèrement, à 62,8 et 64,1 %. L’erreur de prédiction complexe diminue également. Les exemples supervisés aident. L’étape supplémentaire d’optimisation par récompense apporte peu sur cette tâche.
Les vérifications physiques compliquent un classement fondé sur une seule précision. Le taux de passivité vérifie une borne physique. La réciprocité mesure la relation attendue entre transmission directe et inverse. L’erreur de dérivée spectrale mesure l’évolution de la réponse entre fréquences voisines. Un modèle d’image non adapté passe le test de passivité dans 98,5 % des cas tout en plaçant seulement 11,1 % des points dans 2 dB, avec une forte erreur de réciprocité. Une courbe peut donc passer une vérification physique et rester numériquement inexacte ou aplatie.
Après adaptation, le taux de passivité baisse à environ 72 %, tandis que précision, réciprocité et cohérence spectrale progressent. Un CNN surrogate spécialisé donne la meilleure précision point par point, avec 84,4 % des prédictions dans 2 dB. Cependant, seuls 28,3 % de ses fréquences prédites passent le critère de passivité et ses erreurs de réciprocité et de dérivée spectrale dépassent celles des modèles adaptés. Il n’y a pas un vainqueur unique. Chaque méthode combine différemment les propriétés numériques et physiques.
La récompense peut optimiser un substitut au résultat final#
La tâche de diagnostic montre la différence entre une bonne décision et un redesign utile. GPT-5.4-mini mène la classification du besoin d’amélioration, avec 89,0 % d’exactitude et 88,4 de macro-F1. Le SFT fait passer le macro-F1 de Qwen3-VL-8B de 51,0 à 58,6. GRPO atteint 55,5. Pourtant, l’amélioration de bout en bout après simulation ADS descend de 48,4 % pour le backbone à 45,3 % après SFT puis 35,9 % après GRPO. La réduction médiane d’erreur après adaptation reste proche de zéro.
L’article relie cet écart à deux éléments de l’entraînement. Les cas de diagnostic T5 sont exclus du SFT et de GRPO, et la récompense de GRPO provient d’un modèle de substitution au lieu d’exécuter le simulateur complet pour chaque candidat. Le système peut ainsi mieux optimiser la récompense du surrogate sans produire de modifications physiques plus efficaces. Le résultat du simulateur contrôle le lien entre la récompense et la tâche réelle.
Ce motif apparaît aussi dans l’ingénierie de l’IA. Un modèle peut optimiser le signal moins coûteux calculé par sa boucle d’entraînement, alors que l’objectif produit exige une validation plus complète. Vérifier un format coûte moins qu’une simulation, un surrogate est plus rapide qu’un calcul pleine onde. Une récompense corrélée à la cible peut accélérer l’apprentissage, mais cette corrélation doit être mesurée sur des cas retenus et sur le vrai critère d’acceptation. RFBench rapporte l’écart au lieu d’assimiler un progrès de la récompense à un progrès de conception.
La classification des réponses montre aussi l’importance du choix des métriques. Après fine-tuning, l’exactitude dépasse 94 %, mais macro-F1 reste autour de 74 %. Les six classes de réponse sont très déséquilibrées. L’exactitude totale donne beaucoup de poids aux classes courantes. Macro-F1 rend les petites catégories plus visibles. Les deux valeurs expliquent le comportement du modèle. N’en publier qu’une seule masquerait ses difficultés sur les types de réponse les plus rares.
Le périmètre physique reste défini#
RFBench se concentre sur des layouts simulés à deux ports. Il ne modélise ni contraintes de fabrication ni dispositifs mesurés. La grille 16 × 16 représente une aire de conception contrôlée, tandis qu’ADS Momentum fournit la réponse. Cela donne un lien reproductible entre géométrie et électromagnétisme. La production réelle ajoute matériaux, tolérances, empilement, boîtier, connecteurs et bruit de mesure.
La génération des données détermine également ce que le modèle peut apprendre. Cinq familles de géométrie procédurale fournissent chacune 2 000 éléments. Une séparation aléatoire par design garde 1 000 cas pour le test officiel et 9 000 pour l’entraînement. Les auteurs décrivent l’alignement des primitives, images, grilles et réponses et vérifient les doublons et la cohérence de la rastérisation. Ces contrôles sont utiles. Une séparation aléatoire reteste les mêmes familles de générateurs et ne prouve donc pas un fonctionnement sur toutes les topologies qu’un ingénieur RF pourrait dessiner.
Les auteurs indiquent une licence CC BY 4.0 pour le dataset et MIT pour le code. Lors de la vérification des liens fournis dans l’article, l’adresse GitHub renvoyait 404 et la page Hugging Face du dataset exigeait une authentification. Le lecteur peut consulter l’article et ses résultats publiés. La reproduction dépend de l’accès effectif au code et aux données. Cette disponibilité peut évoluer, donc l’annonce d’une publication et la possibilité de télécharger ses artefacts méritent un suivi distinct. Article RFBench et liens d’artefacts
Les résultats de fine-tuning correspondent également à un modèle de base et à une recette précis. Les auteurs appliquent un SFT RF et une étape GRPO à Qwen3-VL-8B. L’adaptation améliore nettement ses performances sur ces tâches. L’article n’établit ni le coût de préparation d’un dataset comparable pour une organisation, ni son gain sur son propre flux, ni le transfert vers des conceptions commerciales. Ces questions nécessitent des expériences sur le processus cible.
Ce que les ingénieurs peuvent lire dans le profil#
La lecture la plus utile consiste à suivre les étapes. Une spécification devient une géométrie. Celle-ci doit passer l’analyse du fichier, les limites et la connectivité. Le simulateur doit l’accepter. La réponse doit respecter les critères fréquentiels et physiques. Le diagnostic doit aboutir à une modification qui réduit réellement l’erreur. S’arrêter à la première étape risque de surestimer ce qui est accompli.
Les résultats indiquent quelques priorités pratiques. Des schémas de sortie contraints et une supervision géométrique précise peuvent améliorer les tâches de représentation. La simulation reste nécessaire pour mesurer le comportement électrique. Les récompenses surrogate doivent être comparées à une simulation complète sur des cas appariés tenus à l’écart. Le déséquilibre des classes appelle des métriques macro. Des panneaux d’évaluation distincts peuvent aussi convenir à la génération, à la simulation et à l’amélioration, dont les coûts diffèrent.
Le choix de modèle dépend du travail visé. Si l’équipe a besoin de convertir des layouts ou classifier leur structure, les scores du modèle adapté sont intéressants dans ce benchmark. Si la tâche exige le respect de toutes les spécifications électriques, les taux stricts de 1,6 à 2,8 % montrent qu’un écart important subsiste. La décision porte sur l’étape que l’on souhaite automatiser et sur le contrôle humain restant. L’assistance à la géométrie peut déjà servir même si la conception inverse autonome n’est pas fiable.
RFBench apporte sept tâches, des représentations communes et des métriques liées au simulateur dans un domaine jusque-là dépourvu d’un test unifié de ce type. Le résultat le plus clair sépare la forme apprise de la fonction physique. Un modèle peut apprendre à produire une forme valide et presque exactement reproduire une grille d’occupation. La prédiction d’un balayage électromagnétique dense reste plus difficile. Respecter tous les objectifs de réponse après simulation l’est davantage encore. Ce profil explique plus qu’une affirmation générale selon laquelle un modèle « sait concevoir des circuits RF ».
Les prochaines preuves devraient inclure des artefacts accessibles, des reproductions indépendantes, davantage de géométries et du matériel mesuré. Un simulateur fournit un modèle physique reproductible, tandis que les dispositifs fabriqués ajoutent tolérances et effets parasites. Les équipes peuvent étudier les tâches publiées pour localiser les échecs d’un modèle. Le benchmark actuel établit une structure de test et documente des progrès après adaptation. Sa valeur principale est d’aider à repérer les écarts entre image, layout et circuit haute fréquence fonctionnel.