Évaluer un modèle de langage exige de décider quoi échantillonner. Les chercheurs peuvent disposer de centaines de tâches, avec un modèle qui réussit un essai et échoue au suivant. Chaque sortie consomme du temps ou de l’argent. Le même budget limité peut couvrir davantage de types de tâches ou mesurer la variabilité en répétant un sous-ensemble. Une simple estimation ponctuelle cache l’incertitude créée par ce choix. Un article révisé le 18 novembre propose d’utiliser les résultats répétés pour resserrer les intervalles de confiance tout en maintenant une garantie statistique précise. Il s’agit d’une méthode de conception de l’évaluation, avec une base de preuves définie, et non d’un nouveau classement de modèles. Article sur l’évaluation LLM à budget fixe
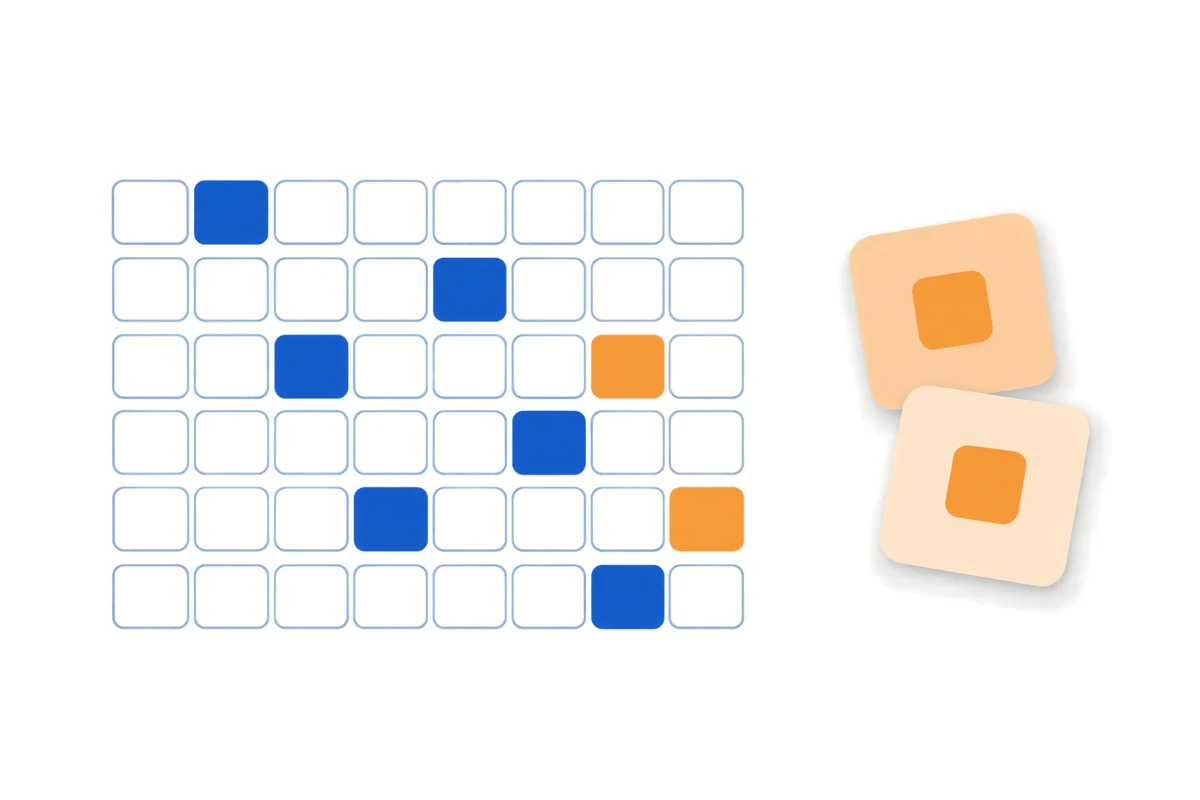
La proposition part d’une situation pratique. Une épreuve de code compte par exemple 880 tâches, chacune exécutée cinq fois, soit 4 400 résultats. Le budget ne permet d’en examiner que 1 100. Il faut donc choisir lesquels observer. Une stratégie directe tire 1 100 couples tâche-exécution de manière uniforme. Le cadre étudié commence par couvrir chaque tâche une fois, puis consacre les 220 sorties restantes à un sous-ensemble aléatoire. Lorsque les résultats répétés concordent dans une tâche, ces audits renseignent sur la variation des exécutions cachées et sur le score total prévu.
Un score de modèle s’accompagne d’une question de précision#
L’évaluation estime une quantité pour un ensemble donné de tâches, d’exécutions et de réglages. Les auteurs appellent cet ensemble défini à l’avance une cohorte fixe. Elle peut inclure une version précise du modèle, les instructions, les paramètres de génération, les questions et le nombre d’essais par question. Dans l’exemple de programmation, la cible est le résultat moyen des 4 400 exécutions tâche-essai prévues. Cette définition est indispensable au sens de l’intervalle de confiance.
Les chercheurs regardent souvent la moyenne estimée. Si un modèle réussit 72 % des tâches échantillonnées, ce nombre semble facile à comparer avec une autre version. Une différence d’un ou deux points peut toutefois compter quand une décision produit dépend d’un seuil. Une équipe doit décider si le modèle remplit les critères de sortie, s’il faut lancer une nouvelle phase d’essais ou si le progrès observé justifie son coût. Un intervalle décrit l’incertitude autour de l’estimation. Il montre si les valeurs plausibles se trouvent de part et d’autre de la ligne de décision.
Un intervalle étroit aide à départager les modèles à niveau de confiance égal. Cette proposition contient deux contraintes. L’intervalle doit préserver la garantie de couverture prévue et l’évaluation doit consommer le même budget. Réduire le niveau de confiance rétrécirait l’intervalle en modifiant sa promesse. Ajouter des tests augmenterait le coût. L’article étudie comment l’échantillonnage peut mieux utiliser les sorties disponibles tout en respectant les deux conditions.
La question concerne particulièrement les modèles et agents stochastiques. Une tâche peut réussir à un essai et échouer au suivant à cause de l’échantillonnage, des outils, de l’exécution du code ou d’un raisonnement prolongé. L’évaluation a donc deux axes. L’échantillonnage entre tâches renseigne sur l’étendue des capacités. Les répétitions sur une même tâche révèlent les variations. Tout le budget consacré à un axe laisse l’autre incertitude en place. Leur proportion dépend des tâches et du plan de répétition.
La cible exige également une règle de score déclarée. L’article étudie un cas binaire où chaque exécution aboutit à une réussite ou un échec déterminant. Dans un benchmark d’agents, une exécution peut contenir plusieurs réponses du modèle ou opérations d’outil. L’unité de coût de la garantie théorique est une sortie ou un épisode, et le budget d’une exécution choisie doit prévoir sa longueur maximale. Cela permet d’énoncer une limite stricte. Les tokens API, le temps écoulé et les montants facturés varient avec la longueur des réponses et l’infrastructure, et ne sont pas automatiquement mesurés.
La cohorte fixe fournit un cadre stable à la comparaison. Elle ne représente pas toutes les tâches et tous les échantillons futurs. Le score décrit les tâches, l’instantané du modèle et les réglages de génération qui définissent cette cohorte. Si une équipe produit change les instructions en cours d’évaluation, les conditions changent également. L’intervalle calculé pour la grille initiale ne prendra pas ce changement en compte. L’évaluation peut être redéfinie avec les nouveaux réglages et une nouvelle cohorte. Cette discipline aide à séparer une amélioration du modèle des effets d’une autre liste de tâches, d’un nombre d’essais différent ou d’une mise à jour du cadre d’exécution. La question mesurée devient explicite.
Les répétitions révèlent la variation au sein d’une tâche#
Une observation par tâche peut estimer une moyenne lorsque chaque tâche a le même poids. Elle renseigne peu sur la variation des autres essais de cette tâche. Si l’échantillon réussit une question, le résultat seul ne permet pas d’inférer que les quatre prochains essais réussiront aussi. L’intervalle doit considérer les résultats cachés possibles, y compris ceux des cohortes dont les tâches varient fortement.
Cette limite persiste même si la moyenne échantillonnée correspond par hasard à la moyenne de tous les résultats prévus. Estimation et précision sont distinctes. L’échantillon peut tomber juste, alors que l’incertitude sur les résultats non observés reste large. L’intervalle doit respecter sa garantie pour chaque cohorte fixe concernée, pas uniquement dans le cas où tous les résultats répétés sont identiques.
Les répétitions jouent le rôle d’audits. Le cadre tire deux résultats distincts dans certaines tâches et compte leurs désaccords. Peu de désaccords indiquent que la variation au sein des tâches peut être faible. Un désaccord signale qu’un nouvel essai peut changer le résultat. La méthode utilise cette observation pour borner la variabilité cachée et éventuellement réduire l’intervalle. Une seule réussite ne fournit pas de comparaison. Elle peut être typique ou exceptionnellement favorable. Les répétitions renseignent sur les résultats du plan d’essais, même quand le jeu complet reste inconnu.
Le cadre ne suppose pas de modèle probabiliste expliquant comment une tâche produit ses résultats. Il tire au hasard des exécutions planifiées au sein d’une cohorte fixe et construit un intervalle qui conserve sa couverture pour tout ensemble possible de résultats. Cette approche est utile lorsqu’un évaluateur ne peut justifier d’hypothèses fortes sur les variations d’exécution. La garantie reste liée au mécanisme d’échantillonnage et à la population finie déclarée.
Un intervalle qui utilise les désaccords observés a un comportement intuitif sur les tâches stables. Des exécutions échantillonnées concordantes sont compatibles avec une faible variance dans la tâche. Deux résultats différents montrent qu’une tentative supplémentaire peut changer son issue. Le calcul convertit cette observation en borne pour les résultats cachés, tout en préservant ceux qui n’ont pas été tirés. Une seule réussite ne fournit pas cette comparaison. Elle peut être courante ou exceptionnellement favorable. Les répétitions renseignent sur les variations prévues, même lorsque l’ensemble complet n’est pas observé.
Pour couvrir toutes les tâches, le cadre sélectionne d’abord uniformément une exécution par tâche, puis une seconde pour un sous-ensemble aléatoire. Cette sélection est terminée avant l’observation des résultats. Ce détail compte car choisir les répétitions en fonction des succès et échecs précédents pourrait biaiser l’estimation. Le tirage aléatoire rend le processus vérifiable. La théorie traite également des stratégies plus adaptatives et fixe des limites même lorsque des choix futurs dépendent des résultats passés.
La couverture des intervalles a un sens précis#
Un intervalle de confiance à 95 % est une procédure qui couvre la cible au moins 95 % du temps lors de tirages répétés sur le même ensemble fixe de résultats. Il ne dit pas qu’après l’observation, il existe 95 % de probabilité qu’un score fixe particulier se trouve dans l’intervalle. Cette probabilité concerne le processus d’échantillonnage. Un intervalle qui adapte sa largeur aux résultats observés doit aussi préserver la couverture promise. Texte intégral de l’article
Les auteurs nomment « honnêtes » les intervalles qui satisfont cette couverture pour toute cohorte fixe. La garantie est exigeante. Elle inclut des désaccords dans une même tâche, des écarts entre tâches et des observations susceptibles d’être dépendantes. Le cadre ne peut donc pas déduire une incertitude faible d’un échantillon chanceux. Il doit borner les valeurs qui restent possibles parmi les résultats non observés.
Quand une exécution peut s’arrêter au premier succès ou échec décisif, un arrêt anticipé peut réduire le coût. Un budget strict doit aussi couvrir une cohorte difficile où les événements arrivent seulement en fin d’exécution. Les parcours partiels ne révèlent alors aucun résultat final et l’évaluateur ne peut achever qu’un nombre limité d’essais. L’article prouve une borne inférieure de l’erreur quadratique moyenne dans ce cas. Cela sépare une stratégie commode d’une garantie applicable à toute cohorte fixe.
Les auteurs prouvent les taux optimaux de contraction de l’intervalle lorsque les exécutions prévues concordent dans chaque tâche, en exigeant ou non une couverture complète. Avec la couverture complète, la largeur dépend à la fois du nombre de tâches et des répétitions supplémentaires. Si l’évaluateur peut omettre des tâches, les sorties libérées financent d’autres répétitions, mais l’intervalle inclut également l’incertitude sur les tâches absentes. Le meilleur taux change car les deux incertitudes entrent dans le calcul.
Ces taux décrivent un régime théorique dans le pire des cas. Ils ne garantissent pas une réduction fixe sur une nouvelle évaluation. Des désaccords fréquents révèlent une variabilité élevée dans les tâches. Des résultats concordants permettent au cadre de réduire la borne selon ses garanties et son plan d’échantillonnage. Le gain dépend du nombre de tâches, des essais prévus, du budget, des désaccords observés et des besoins de couverture.
La couverture complète et les audits répétés créent un arbitrage#
Avec une couverture complète, l’évaluateur obtient au moins un résultat pour chaque tâche. C’est utile lorsqu’un élément du benchmark peut déterminer une décision de publication ou qu’une équipe a besoin d’un profil complet. Les répétitions consomment des sorties qui auraient pu couvrir davantage d’essais ailleurs. Le plan de couverture complète tire une exécution uniforme pour chaque tâche et une seconde pour un sous-ensemble aléatoire. Il fait la moyenne dans chaque tâche, puis attribue le même poids à chacune.
Si une couverture complète n’est pas obligatoire, l’évaluateur peut omettre au hasard certaines tâches et employer les sorties libérées à plus de répétitions ailleurs. L’intervalle doit alors intégrer l’incertitude des tâches jamais échantillonnées, en plus de celle des exécutions cachées dans les tâches sélectionnées. Omettre des questions ne donne pas de précision gratuite. Le score cible reste la moyenne de l’ensemble initial, et les tâches absentes font toujours partie du calcul d’incertitude.
L’article prouve des bornes inférieures pour les deux plans. Les garanties à budget strict s’appliquent à tous les évaluateurs, y compris ceux qui choisissent l’exécution suivante à partir des résultats précédents. Une cohorte extrême place l’événement décisif à la fin de chaque parcours. Les exécutions incomplètes révèlent alors peu d’information. Des désaccords cachés peuvent rendre deux cohortes fixes compatibles avec le même échantillon tout en leur donnant des scores différents. Un intervalle honnête doit couvrir les deux possibilités, ce qui limite les promesses à petit budget.
Dans les expériences, l’intervalle pratique s’appelle Joint. Il utilise le nombre de désaccords entre paires de résultats répétés pour borner l’erreur de score, puis le combine avec l’estimation observée. Il croise également le résultat avec les valeurs encore possibles d’après les étiquettes visibles. Cela ne coûte aucune sortie supplémentaire. L’article le compare à une référence uniforme fixe, qui échantillonne des couples tâche-exécution dans toute la grille et utilise la distribution exacte du nombre de réussites.
Autoriser l’omission de tâches relève du but de l’évaluation. Un rapport général sur les capacités peut devoir couvrir chaque catégorie. Un benchmark interne de déploiement peut échantillonner les tâches représentatives du travail client et consacrer davantage au suivi répété. L’équipe devrait définir la population cible, le poids des tâches et la possibilité de les omettre. Sans cette définition, un intervalle plus étroit peut répondre à une autre question que celle de l’organisation.
Le replay de LiveCodeBench utilise un budget fixe#
La comparaison empirique rejoue des résultats déjà enregistrés dans LiveCodeBench. Pour 16 configurations de modèles, les auteurs prennent les cinq premiers résultats de réussite ou d’échec sur chacune de 880 tâches de programmation. Chaque configuration forme ainsi une cohorte de 4 400 sorties prévues. L’article compare les intervalles à 1 100 sorties et au niveau de confiance de 95 %. Le plan complet choisit une sortie aléatoire par tâche et répète 220 tâches choisies au hasard.
Au même nombre de sorties, Joint produit un intervalle moyen plus étroit que l’échantillonnage uniforme dans 15 configurations sur 16. La réduction médiane de largeur est de 30,6 %. Ce résultat concerne les configurations rejouées et les observations enregistrées selon le protocole décrit. Il montre l’utilité des répétitions dans ce cadre. Il ne prédit pas la même réduction pour chaque benchmark, famille de modèles ou plan d’évaluation. Détails du replay LiveCodeBench
L’unité du budget expérimental est la sortie. Les tâches LiveCodeBench possèdent un résultat fini de réussite ou d’échec. Les exécutions de modèles réels peuvent consommer des tokens, des appels d’outils et du temps en quantités variables. Pour un service qui facture chaque tentative de façon identique, le nombre de sorties correspond mieux au coût. Une équipe avec des tâches très différentes en longueur doit fixer une limite de coût dur pour les parcours variables ou conduire une autre analyse de la dépense.
L’utilisation d’observations enregistrées rend le test pratique et transparent, avec une condition. Les 1 100 sorties sont échantillonnées dans une grille préexistante de cinq résultats par tâche. Le replay compare les stratégies sur cette cohorte fixe. Il ne crée pas de nouveaux échantillons du comportement futur d’un modèle. De nouvelles versions, consignes, tâches ou conditions d’exécution peuvent produire d’autres désaccords et d’autres largeurs d’intervalle.
L’article étudie aussi des variations contrôlées de l’accord dans une tâche et des parcours plus longs. Ces expériences aident à comprendre le rôle des répétitions et l’effet de la longueur des exécutions sur le budget. Les constats empiriques restent propres aux tâches, résultats enregistrés et configurations étudiés. Le lecteur peut utiliser la théorie pour comprendre la méthode, puis considérer chaque application comme un nouveau problème de mesure.
Une limite stricte est différente de la gestion d’une dépense moyenne. Un flux qui s’arrête à la première réussite peut souvent traiter davantage de tâches faciles pour la même consommation moyenne. Un plafond dur doit tenir dans la combinaison de résultats la plus coûteuse. L’article réserve donc suffisamment de budget pour qu’une exécution choisie atteigne son parcours maximal. La garantie porte sur un nombre maximal de sorties ou d’épisodes même si certains parcours s’arrêtent plus tôt. Une équipe facturée à l’API peut calculer séparément les réponses de tailles différentes, les tentatives et les appels d’outils. Elle pourra les intégrer au plan une fois leur relation avec les exécutions déterminée.
Le cadre redéfinit le plan d’évaluation#
Pour un benchmark aux essais stochastiques répétés, le plan doit d’abord définir la cohorte. Il comprend la version du modèle, les tâches, les instructions, les réglages, le nombre d’essais et la règle de réussite. La cohorte fixe la cible. Le plan d’échantillonnage choisit ensuite les observations. L’intervalle qui en résulte décrit l’incertitude sur la moyenne prévue, avec ces conditions, sans couvrir automatiquement toutes les futures instructions et charges de travail.
Cette précision est particulièrement utile pour une décision proche d’un seuil. Supposons que le taux de réussite d’un modèle passe de 79 à 81 %, alors que le seuil est de 80 %. La moyenne ne montre pas la part du changement imputable aux tâches et répétitions échantillonnées. Un intervalle étroit entièrement d’un côté du seuil peut soutenir une décision. Un intervalle large peut justifier des essais supplémentaires. Le cadre propose de répartir un nombre fixe de sorties en utilisant l’accord observé dans chaque tâche pour affiner l’intervalle.
Les répétitions peuvent aussi diagnostiquer une suite. Les tâches très divergentes peuvent être stochastiques, sensibles aux instructions ou affectées par l’environnement d’exécution. Les répétitions rendent cette variation visible. Les tâches concordantes fournissent un autre type d’information. Le cadre ne diagnostique pas la cause des désaccords. Traces, analyse des instructions et revue des échecs restent nécessaires pour distinguer raisonnement du modèle, panne d’un outil, données non déterministes ou correcteur instable.
L’omission de certaines tâches entraîne une autre décision produit. Un rapport public large peut exiger chaque catégorie. Une décision interne peut se concentrer sur les tâches représentatives des clients tout en estimant un score pondéré défini à l’avance. Si les poids ne sont pas égaux, l’échantillonnage doit en tenir compte. Les preuves de l’article précisent leur cible et permettent de reconnaître quand un schéma de pondération différent nécessite un intervalle adapté.
La garantie dépend aussi de la règle d’échantillonnage. Audit, Joint, tirage uniforme fixe et politiques adaptatives ont des propriétés différentes. Une équipe ne devrait pas transposer directement la réduction de 30,6 % à ses propres tests. Elle peut mettre en place un plan, définir son objectif et son niveau de confiance, puis vérifier le calcul de l’intervalle. L’article fournit la théorie des méthodes étudiées et les conditions du replay.
Ce que le résultat établit#
L’article propose un plan d’échantillonnage pour des résultats binaires répétés sous un budget strict de sorties. Il utilise les désaccords dans une tâche afin de construire un intervalle de confiance honnête, prouve des taux limites avec couverture complète et facultative, puis teste la méthode sur une grille historique de LiveCodeBench. Avec le même budget nominal, les intervalles sont plus étroits pour la majorité des configurations testées, avec une baisse médiane de 30,6 %.
Le résultat porte sur la précision de l’évaluation. La moyenne du modèle et son incertitude sont liées, mais répondent à deux questions. Des exécutions répétées peuvent révéler une variation qu’un seul essai cache. Le cadre formalise comment ces observations contribuent à l’intervalle en maintenant une garantie de couverture sur la population d’essais prévue.
La principale limite est l’interprétation des coûts. Un plafond en nombre de sorties se reproduit facilement sur une tâche binaire de programmation. Dollars, tokens et temps réel ne sont pas automatiquement équivalents pour des charges différentes. L’extrapolation reste également liée aux 16 configurations et à la cohorte de cinq essais enregistrée. De futures versions de modèles et d’autres benchmarks peuvent se comporter autrement. Les équipes peuvent reprendre le principe en déclarant leur population, leur unité de coût et les conditions des tâches.
Une comparaison fiable dépend à la fois de l’estimation et du plan d’échantillonnage qui la soutient. Cet article place le plan au cœur de l’évaluation. Son idée centrale est qu’en répétant certaines tâches l’évaluateur observe leur désaccord et peut estimer la variation que les exécutions non vues apporteront au score. Le replay LiveCodeBench donne un exemple de précision récupérée avec un budget de sorties fixe. D’autres applications montreront comment l’avantage évolue avec les tâches, résultats et coûts d’exploitation.